מאילו מקורות משתמש Perplexity בעת המלצה על עסקים ותוכנות?
למדו כיצד Perplexity בוחר מקורות בעת המלצה על עסקים ותוכנות — החל בדפי אינטרנט ופלטפורמות ביקורת, דרך פורומים ותיעוד רשמי ועד שותפי נתונים פרמיום. המאמר מסביר כיצד סוג השאילתה ומצבי המיקוד משפיעים על מה שמצוטט.
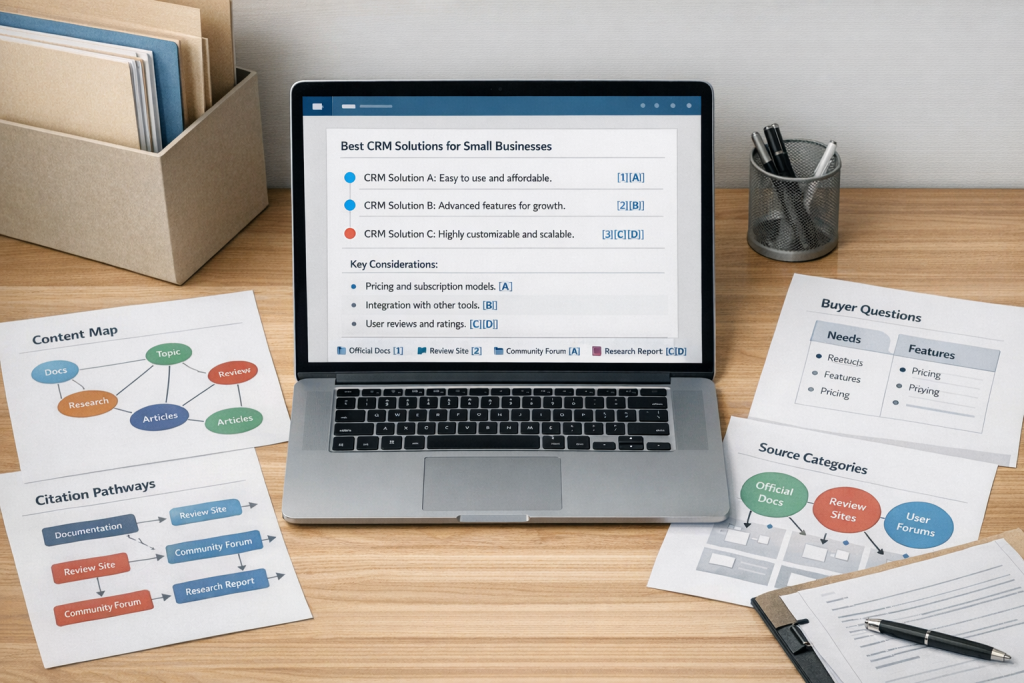
אילו מקורות משתמשת בהם Perplexity בעת המלצה על עסקים או תוכנות?
Perplexity אינה מנהלת ספרייה קבועה של עסקים מאושרים או מוצרי תוכנה. כל שאילתה מפעילה תהליך אחזור חי שמרכיב תשובות משילוב משתנה של תכני אינטרנט, פלטפורמות ביקורות, תיעוד רשמי, דיונים קהילתיים — ועבור מנויי Pro ו-Enterprise — שותפי נתונים פרימיום מורשים. המקורות שמופיעים בכל תשובה נתונה תלויים באופי השאלה, ברמת הספציפיות של השאילתה, ובמה שמערכת האחזור שופטת כרלוונטי ביותר באותו רגע.
מאמר זה מפרק כל קטגוריית מקור שממנה שואבת Perplexity, מסביר כיצד סוג השאילתה משנה את תמהיל המקורות, סוקר את מצבי המיקוד המאפשרים למשתמשים לכוון את מאגר המקורות, ומתייחס למה שכל זה אומר עבור עסקים וספקי תוכנה המנסים להבין את הנראות שלהם בתוך תשובות שנוצרות על ידי בינה מלאכותית.
כיצד Perplexity מאחזרת מקורות עבור כל שאילתה
Perplexity פועלת כמנוע תשובות ולא כמנוע חיפוש מסורתי. משתמש מגיש שאלה ומקבל תגובה מסונתזת עם ציטוטים מוטבעים — לא רשימה ממוינת של קישורים ללחיצה. המערכת מאחזרת תוכן מרחבי האינטרנט בזמן אמת, משתמשת בתוכן זה לבניית תשובה ישירה, ומקשרת כל טענה בחזרה למקור ממנו היא נלקחה, כדי שהקורא יוכל לאמת את המידע.
הגישה הטכנית שעומדת מאחורי כך היא retrieval-augmented generation, בראשי תיבות RAG. המשמעות המעשית: מודל השפה הבסיסי אינו מסתמך אך ורק על מה שלמד במהלך האימון. עבור כל שאילתה, הוא מחפש באינטרנט, שולף תוכן מהדפים שהוא רואה כרלוונטיים ביותר, ומשתמש בחומר שאוחזר כדי לעצב את התגובה. התשובה נוצרת מחדש עבור כל שאילתה, והמקורות המצוטטים עשויים להשתנות בהתאם למה שפורסם לאחרונה, מה שנגיש כרגע, וכמה קרוב דף נתון לשאלה הנשאלת.
זו הסיבה מדוע שני אנשים ששואלים גרסאות שונות במעט של אותה שאלה עשויים לקבל תשובות המצטטות מקורות שונים לחלוטין. האחזור הוא חי וספציפי לשאילתה, ואינו נשאב ממטמון קבוע.
נקודה מרכזית: ציטוטים מוטבעים בתשובות Perplexity אינם קוסמטיים. הם הדרך של המערכת להראות אילו דפים היא אחזרה, העריכה, והשתמשה בהם כבסיס לחלקים ספציפיים של תגובתה. כל קישור מצוטט מייצג דף שעבר את סף הרלוונטיות של מערכת האחזור עבור אותה שאילתה ספציפית.
קטגוריות המקורות המרכזיות שממהן שואבת Perplexity
Perplexity אינה פועלת מרשימת מקורות מאושרת יחידה. היא שואבת ממספר קטגוריות תוכן נבדלות, ואילו קטגוריות שולטות בכל תשובה נתונה תלוי בשאילתה. הבנת קטגוריות אלה היא יסוד להבנת מדוע דפים מסוימים מופיעים בהמלצות בינה מלאכותית ואחרים לא.
תוכן אינטרנט כללי ופרסומים בעלי סמכות גבוהה
רוב השאילתות מתחילות ברשת הפתוחה. זה כולל אתרי חדשות, פרסומים ענפיים, סיכומים שנוצרו בעריכה מקצועית, מדריכים סמכותיים ארוכי-טווח, ונכסי דומיין מבוססים היטב. מערכת האחזור נראית כמי שמעדיפה דפים עם תוכן מהותי ועשיר במידע על פני דפים שהם בעיקרם פרסומיים או דלים מבחינה מבנית.
דפוסים שנצפו מצביעים על כך שדפים בעלי ארגון ברור, טענות עובדתיות ספציפיות וסמכות נושאית מוכחת נאחזים ומצוטטים באופן עקבי יותר. דפים שנבנו סביב שפת מכירות אגרסיבית, תוכן מקורי מינימלי או מילוי מילות מפתח נוטים לסינון או לדילוג עליהם לטובת חלופות מהותיות יותר.
פלטפורמות לסקירה והשוואה של תוכנות
כאשר שאילתה מבקשת מ-Perplexity להמליץ על תוכנה — בין אם מדובר בכלי ניהול פרויקטים, פלטפורמות CRM, תוכנות הנהלת חשבונות, או כל קטגוריה אחרת — המערכת שואבת לעיתים קרובות מפלטפורמות ייעודיות לסקירה והשוואה. G2, Capterra ו-TrustRadius הם בין המקורות הנצפים ביותר בקטגוריה זו.
פלטפורמות אלו עולות לפני השטח מפני שהן מאחדות ביקורות משתמשים מובנות, השוואות תכונה-לפי-תכונה, נתוני תמחור ודירוגי קטגוריות במקום אחד. עבור מערכת אחזור המרכיבה המלצת תוכנה, סוג כזה של תוכן מאורגן והשוואתי שימושי ישירות.
מה שמצוטט מפלטפורמות אלו הוא לעיתים קרובות לא דף הבית. Perplexity שואב באופן קבוע מדפי קטגוריה ספציפיים, פרופילי מוצר בודדים, דפי השוואה ישירה וסיכומי ביקורות — כל דף שתואם ביותר את פרטיות מה שנשאל.
מקורות רשמיים של ספקים וחברות
Perplexity מצטט לעיתים קרובות דפים רשמיים של חברות כאשר שאילתה עוסקת במוצר או עסק ספציפי. דפי מוצר, דפי תמחור, מרכזי תיעוד, מרכזי עזרה, דפי אודות והודעות לעיתונות — כולם נכללים בקטגוריה זו.
דפים אלו נוטים להופיע לרוב כאשר השאילתה צרה וספציפית למוצר — שאלה מה חברה מסוימת מציעה או כיצד תכונה ספציפית עובדת — ולא כאשר השאילתה היא השוואת קטגוריה רחבה. עבור שאלות פתוחות לרווחה כמו “ה-CRM הטוב ביותר לעסקים קטנים”, Perplexity נוטה להישען על מקורות צד שלישי. עבור שאלות מוצר ממוקדות, סביר יותר שהוא יפנה ישירות לתוכן של הספק עצמו.
ההשלכה המעשית: אם התיעוד הרשמי של מוצר חברה מיושן, מאורגן בצורה גרועה, או מובנה בדרכים המקשות על סורקים לעבד אותו, Perplexity עשוי לצטט גרסה ישנה יותר של אותו תוכן, לחזור לתיאור של צד שלישי, או לעקוף את החברה לחלוטין.
דיונים קהילתיים ופורומים
שרשורי Reddit, תשובות Quora, פורומים למפתחים וקהילות תעשייתיות נישתיות מופיעים באופן קבוע בציטוטים של Perplexity — במיוחד בשאילתות בעלות ממד רגשי או ממד חוויה. שאלות כמו “מה משתמשים אמיתיים חושבים על המוצר הזה”, “האם הכלי הזה באמת שווה את המחיר” או “ספק השירות הטוב ביותר בעיר הזו” מציפות לעתים קרובות דיונים קהילתיים כמקורות ראשיים או תומכים.
המערכת נוטה להעדיף תוכן קהילתי כאשר אופי השאילתה מאותת שהמשתמש מחפש חוויית משתמש אותנטית במקום טענות שיצר הספק. מותגים עם נוכחות אמיתית בקהילות רלוונטיות — דרך שיחות משתמשים אורגניות, לא פוסטים מלאכותיים — נותנים ל-Perplexity חומר מקור נוסף לעבוד איתו כאשר מגיעות שאילתות מוכוונות חוויה אלו.
ההפך נכון גם כן. מותג ללא נוכחות משמעותית בדיונים קהילתיים עלול לגלות ש-Perplexity פשוט יש לו פחות חומר לעבוד איתו כאשר משתמשים שואלים שאלות מוכוונות חוויה על אותה קטגוריה.
שותפי נתונים ברישיון פרמיום
מנויי Perplexity Pro ו-Enterprise מקבלים תשובות שיכולות להסתמך על מקורות נתונים ברישיון פרמיום שאינם זמינים ברשת הפתוחה. אלו מאגרי מידע ברמה מקצועית שאיתם ביסס Perplexity שותפויות כדי להעמיק את איכות תשובותיו לשאילתות עסקיות, פיננסיות ומחקר שוק.
שותפי הפרמיום המאושרים ומה שכל אחד מביא למאגר המקורות:
- PitchBook: מודיעין שוק פרטי המכסה פירמוגרפיה, סיבובי מימון, פרופילי משקיעים ופעילות עסקאות. הרלוונטי ביותר לשאילתות על סטארט-אפים, חברות הנתמכות על ידי הון סיכון ודינמיקת שוק פרטי.
- CB Insights: מעקב אחר סטארט-אפים, מיפוי שוק, ניתוח נוף תחרותי ונתוני מגמות בתעשייה. הרלוונטי ביותר לשאילתות אסטרטגיה ארגונית ומחקר שוק.
- Statista: סטטיסטיקות גלובליות, נתוני גודל שוק, תחזיות תעשייה ונתוני מחקר צרכנים. הרלוונטי ביותר לשאילתות הדורשות מידע שוק מכומת.
- IBISWorld: דוחות מחקר תעשייתי וניתוח תנאי שוק. הרלוונטי ביותר לשאילתות על ענפי תעשייה ספציפיים ודינמיקת סקטורים.
- Dun & Bradstreet: נתוני אשראי עסקי, פרופילי חברות, רשומות פירמוגרפיות B2B והערכת סיכון מסחרי. הרלוונטי ביותר לשאילתות על אמינות עסקית, בדיקת ספקים ומחקר רקע על חברות.
- Guidepoint: גישה לרשת מומחים ומחקר ראשוני. הרלוונטי ביותר לשאילתות מתמחות המרוויחות מנקודת מבט ברמת מומחה.
- Wiley: כתבי עת אקדמיים ומקצועיים, חומר עיון עסקי ו-STEM. הרלוונטי ביותר לשאילתות הדורשות מקורות עמיתים או מלומדים.
מקורות פרמיום אלה מופיעים לרוב בשאילתות ארגוניות מסוג B2B, בבקשות מודיעין תחרותי, בשאלות תמחור שוק ובמחקר פיננסי. משתמש רגיל בחינם לא יראה תשובות המבוססות על מסדי נתונים אלה, מה שאומר שתמהיל המקורות לאותה שאלה יכול להשתנות באופן משמעותי בהתאם לרמת המנוי של המשתמש.
כיצד סוג השאילתה משנה את תמהיל המקורות
אחד ההיבטים המשמעותיים ביותר ופחות הנדונים של התנהגות המקורות של Perplexity הוא שתמהיל המקורות משתנה באופן ניכר בהתאם לסוג השאלה הנשאלת. שאילתת עסק מקומי, שאילתת השוואת תוכנות ושאילתת מחקר ארגוני מסוג B2B נוטות כל אחת לשאוב מקטגוריות מקורות שונות ביחסים שונים.
שאילתות עסקים מקומיות
כאשר מישהו מבקש מ-Perplexity את חברת HVAC הטובה ביותר בעיר מסוימת או ייצוג משפטי מדורג גבוה בסביבה, המערכת נוטה לשאוב מפלטפורמות ביקורת מקומיות, נתוני Google Business Profile, Yelp, ספריות ספציפיות לתעשייה ודיונים קהילתיים. אתר האינטרנט של העסק עצמו עשוי להופיע, אך התשובה מעוגנת בדרך כלל באותות אמינות של צד שלישי — דירוגים, ביקורות ונוכחות בספרייה המקומית.
שאילתות השוואת תוכנות
שאילתה המבקשת את תוכנת ניהול הפרויקטים הטובה ביותר לצוות בגודל מסוים מסיטה את תמהיל המקורות לעבר פלטפורמות ביקורת תוכנה כמו G2, Capterra ו-TrustRadius, לצד סקירות עריכה מפרסומים טכנולוגיים ותיעוד ספק רשמי. דיונים קהילתיים מ-Reddit או פורומי מפתחים עשויים להופיע גם כן, בעיקר כאשר השאילתה כוללת העדפה או אילוץ שפלטפורמות הביקורת אינן מתייחסות אליהם ישירות.
שאילתות מחקר ארגוני מסוג B2B
שאילתה לגבי ספקי אבטחת סייבר מובילים עבור חברות שירותים פיננסיים בשוק האמצעי נוטה לשאוב מדוחות אנליסטים בתעשייה, שותפי נתונים פרמיום למנויי Pro, פרסומים עסקיים ותוכן עריכה סמכותי. פלטפורמות ביקורת עדיין עשויות להופיע, אך תמהיל המקורות נוטה לעבר תוכן מתמחה ומעמיק יותר. זהו סוג השאילתה שבו שותפי נתוני פרמיום כמו PitchBook, CB Insights ו-IBISWorld הם בעלי הסיכוי הגבוה ביותר להיות חלק מהתשובה.
המסקנה המעשית: עסק שמנסה להבין את הנראות שלו ב-Perplexity צריך לחשוב היטב על סוג השאילתה שקונה פוטנציאלי היה מגיש בפועל — ולאחר מכן להעריך האם למותג יש תוכן רלוונטי ונגיש בקטגוריות המקורות שמהן שואב Perplexity לאותו סוג שאילתה ספציפי.
מצבי מיקוד וכיצד הם שולטים בבחירת המקורות
Perplexity מעניקה למשתמשים את היכולת לצמצם את מאגר המקורות עבור כל שאילתה באמצעות מצבי מיקוד. בחירת מצב מיקוד משנה את קטגוריות התוכן שמערכת האחזור נותנת להן עדיפות בעת הרכבת תשובה.
מצבי המיקוד הזמינים כוללים:
- אינטרנט: הגדרת ברירת המחדל. שולף ממגוון מלא של מקורות אינטרנט נגישים לציבור.
- Academic: מעדיף מחקרים שעברו ביקורת עמיתים, כתבי עת אקדמיים ומסדי נתונים אקדמיים.
- Social: מעדיף פלטפורמות מדיה חברתית ותכנים חברתיים הנגישים לציבור.
- Reddit: מצמצם את השליפה באופן ספציפי לשרשורי Reddit ולדיוני קהילה.
- YouTube: מעדיף תכני וידאו המתארחים ב-YouTube.
- Writing: מסיט את המודל לעבר יצירת טקסט במקום שליפת מקורות וציטוט.
מצבי המיקוד חשובים מפני שהם מעניקים למשתמש שליטה ישירה על סוג המקור המעצב את התשובה. מי שמחפש במצב Reddit את תוכנת הנהלת החשבונות הטובה ביותר לפרילנסרים יקבל תשובה הבנויה כולה מדיוני Reddit. משמעות הדבר היא שהמוצרים שיוזכרו יהיו אלו המופיעים אורגנית בשיחות Reddit — לא בהכרח אלו בעלי הפרופילים החזקים ביותר בפלטפורמות ביקורת או דפי השיווק המלוטשים ביותר.
Perplexity מציעה גם מצב Deep Research המרחיב את היקף השליפה. Deep Research מפעיל תהליך חיפוש יסודי יותר, שואב ממגוון רחב יותר של מקורות ומפיק תשובות ארוכות ומפורטות יותר. עבור שאילתות של המלצות עסקיות ותוכנה, מצב Deep Research נוטה להציג מגוון מקורות רחב יותר — כולל שותפי נתונים פרמיום, תכנים אקדמיים ופרסומים מקצועיים נישתיים שעשויים שלא להופיע בשאילתה רגילה.
מה הופך מקור לסביר יותר להופיע בתשובות Perplexity
לאף אחד מחוץ ל-Perplexity אין נראות לגבי האופן המדויק שבו מערכת השליפה שלה מדרגת ומבחרת מקורות. אך דפוסים עקביים שנצפו על פני מספר רב של שאילתות מצביעים על מאפיינים שדפים המצוטטים לעתים תכופות נוטים לשתף.
- רלוונטיות ישירה לשאילתה: דפים המתייחסים לשאלה הספציפית הנשאלת — ולא לנושא סמוך בלבד — מצוטטים בעקביות רבה יותר. דיוק עולה על רוחב.
- עדכניות: בנושאים שבהם המידע משתנה באופן קבוע, כגון תכונות תוכנה, תמחור או פרטי חברה, דפים שעודכנו לאחרונה נראים מועדפים על פני תכנים ישנים יותר.
- נגישות לסורק: Perplexity מפעילה את הסורק שלה. דף החוסם את הסורק הזה או שאינו מוצג ב-HTML נגיש אינו יכול להישלף או להיות מצוטט, ללא קשר לעוצמת התוכן שבו.
- צפיפות מידע: דפים עם תוכן מפורט ועשיר בעובדות מצוטטים לעתים קרובות יותר מאשר דפים עם תוכן דל, עותק שבלוני או שפה הנקראת בעיקר כפרסומית.
- אותות סמכות נושאית: סמכות דומיין, אמינות עריכתית ומומחיות מוכחת בנושא הספציפי נראים כמשפיעים על בחירת המקורות — אם כי סמכות כאן משמעה אמינות בנושא הספציפי, לא רק עוצמת הדומיין הכוללת.
- אימות צולב בין מקורות: כאשר טענה מופיעה באופן עקבי במספר מקורות, יש סיכוי גבוה יותר ש-Perplexity יכלול אותה בתשובתו ויצטט את הדפים התומכים בה.
אלה הם דפוסים הנגזרים מתצפית, לא כללים פנימיים מאושרים. לוגיקת האחזור של Perplexity היא קניינית. אך הדפוסים עקביים מספיק על פני שאילתות חוזרות כדי לשמש מסגרת עבודה מעשית.
הבחנה חשובה: סריקה על ידי הסורק של Perplexity אינה זהה לציטוט בתשובת Perplexity. דף יכול להתקיים באינדקס מבלי להופיע אי פעם כמקור מצוטט. ציטוט דורש שהדף יהיה ניתן לאחזור ויוערך כאחת האפשרויות הרלוונטיות והאמינות ביותר עבור שאילתה ספציפית ברגע שהיא מוגשת.
מה המשמעות עבור עסקים וספקי תוכנה
אם Perplexity שואב מפלטפורמות ביקורות, דיונים קהילתיים, תיעוד רשמי, פרסומים עריכתיים ושותפי נתונים פרמיום — והתמהיל משתנה לפי סוג השאילתה — אז עסק המעוניין להבין את הנראות שלו בחיפוש ה-AI צריך לחשוב על כל אותם משטחים, לא רק על האתר שלו.
כך נראה הדבר בפועל:
- נוכחות בפלטפורמות ביקורות היא חלק ממשוואת הנראות. כאשר רוכשי תוכנה שואלים את Perplexity לקבלת המלצות והמערכת שואבת מ-G2 ו-Capterra, פרופיל עדכני ומתוחזק היטב בפלטפורמות אלה משפיע ישירות על כך אם מותג יופיע בתשובה.
- טביעת הרגל הקהילתית מעצבת את מה ש-Perplexity יכול לעבוד איתו. כאשר Perplexity מציף שרשורי Reddit ודיוני פורומים עבור שאילתות מוכוונות חוויה, מותגים עם נוכחות קהילתית אמיתית מספקים למערכת חומר מקור רב יותר לשאוב ממנו בשמם.
- התיעוד הרשמי צריך להיות נגיש ועדכני. אם דפי המוצר, מרכז העזרה או דף התמחור של חברה מיושנים, חסומים בפני סורקים, או מאורגנים בדרכים שקשה לנתח, Perplexity עשוי לדלג עליהם לטובת תיאורים של צד שלישי לאותו מוצר.
- תוכן הבנוי סביב שאלות קונים אמיתיות מניב תוצאות שונות מתוכן בלוג גנרי. דף המתייחס ישירות לשאלה ספציפית שקונה היה שואל — עם מבנה ברור, טענות ספציפיות וראיות תומכות — ממוקם טוב יותר להתאים ללוגיקת האחזור מאשר פיסת תוכן רחבה של מודעות שנכתבה למלא לוח זמנים לפרסום.
- כיסוי נתונים פרמיום חשוב למותגים המכוונים לארגונים. כאשר משתמשי Perplexity Pro מקבלים תשובות המבוססות על PitchBook, CB Insights, או Dun & Bradstreet, חברות המכוונות לארגונים צריכות להבין האם יש להן נוכחות באותן מסדי נתונים כלל.
אף אחד מהאמור אינו ערובה. אף עסק אינו יכול לכפות על Perplexity לצטט דף ספציפי או לכלול מותג ספציפי בהמלצה. אך הבנת קטגוריות המקורות שמהן שואבת המערכת — והערכה של האם למותג יש תוכן רלוונטי, נגיש ואמין בכל אותן קטגוריות — היא הבסיס לכל אסטרטגיית נראות AI מעשית.
זו העבודה ש-CiteHarbor מבצעת עבור לקוחות. אנו מבצעים ביקורת על היכן מותג מופיע כיום — והיכן הוא נעדר — בסביבות חיפוש AI כולל Perplexity, ChatGPT, Gemini, Claude ו-Google AI Overview. אנו חוקרים את שאלות הקונים המניעות המלצות בקטגוריה של הלקוח. אנו מייצרים תוכן המיועד להתמודד עם אותן שאלות עם המבנה, הספציפיות והעומק שמערכות אחזור AI נוטות לאחזר. ואנו מנהלים את הביצוע המלא — פרסום ב-WordPress, הפצה בערוצים חברתיים, מעקב אחר ציטוטים מדי חודש, ניטור נראות המתחרים ומסירת תמונות מצב ביצועים ממותגות — כך שהלקוח אינו צריך לנהל פלטפורמה נוספת או תהליך עבודה נוסף.
המטרה אינה לתמרן אף מנוע AI. המטרה היא להבטיח שלמותג יש תוכן שימושי, ניתן לאיתור ומובנה היטב במקומות שבהם מערכות AI כבר מחפשות.
שאלות נפוצות
האם Perplexity משתמש ב-Google או ב-Bing כדי למצוא מקורות?
כן. Perplexity משתמש במספר API-ים של חיפוש, כולל Google ו-Bing, לצד הסורק הקנייני שלו לאינטרנט. תוצאות ממקורות אלה משולבות להרכבת מאגר המקורות לכל שאילתה. המערכת אינה מוגבלת למדד של מנוע חיפוש בודד.
האם Perplexity משתמש במקורות אמינים?
Perplexity מיישם לוגיקת סינון שנראה שמעדיפה תוכן עשיר במידע, אובייקטיבי וסמכותי על פני דפים דלים או שיווקיים מאוד. מערכת הציטוט המוטבע מוסיפה שכבת שקיפות — כל מקור מצוטט מקושר ישירות בתשובה כך שהקורא יכול להעריכו באופן עצמאי. עם זאת, אין מערכת אחזור בלתי ניתנת לטעות, ועל הקוראים להעריך מקורות מצוטטים לפי יתרונותיהם.
מה ההבדל בין המקורות החינמיים לפרימיום של Perplexity?
תשובות ברמה החינמית שואבות מתוכן אינטרנט הזמין לציבור — אתרים, פלטפורמות ביקורות, פורומים, אתרי חדשות ופרסומים עריכתיים. מנויי Pro ו-Enterprise מקבלים תשובות שיכולות לשאוב משותפי נתונים פרימיום מורשים כולל PitchBook, CB Insights, Statista, IBISWorld, Dun & Bradstreet, Guidepoint ו-Wiley. מקורות פרימיום אלה מוסיפים עומק לשאילתות עסקיות, פיננסיות ומחקר שוק שהאינטרנט הפתוח לבדו אינו יכול לתמוך בהן במלואן.
האם עסקים יכולים להשפיע על האם Perplexity ממליץ עליהם?
אף עסק אינו יכול לכפות ציטוט. עם זאת, עסקים יכולים לשפר את סיכוייהם להיות ניתנים לאחזור על ידי שמירה על תוכן עדכני ומובנה היטב בכל קטגוריות המקורות שמהן Perplexity שואב — כולל האתר שלהם, פלטפורמות ביקורת רלוונטיות, דיונים קהילתיים ופרסומים בתעשייה. המטרה היא להיות נוכחים, נגישים ובעלי תועלת אמיתית במקומות שבהם מערכת האחזור של Perplexity מחפשת מידע.
האם ל-Perplexity צריכה להיות תכנית פרומפט ותוכן נפרדת מ-SEO?
לאו דווקא תכנית נפרדת לחלוטין, אלא הרחבה מכוונת של אסטרטגיית התוכן הקיימת. האיכויות שהופכות דף לשימושי עבור מערכת האחזור של Perplexity — מבנה ברור, תשובות ישירות לשאלות אמיתיות, עומק מהותי, גישת סריקה — חופפות באופן משמעותי לתרגול SEO תקין. ההבדל הוא בדגש: מערכות אחזור של בינה מלאכותית נוטות להעדיף תשובות תמציתיות וניתנות לחילוץ ומקטעים מאורגנים היטב, בעוד שה-SEO המסורתי עשוי לתגמל גישות תוכן רחבות יותר. רוב העסקים נהנים יותר מהטמעת חשיבת הנראות ב-AI בתוך זרימת העבודה הקיימת שלהם לתוכן, במקום לטפל בה כתכנית נפרדת לניהול.
מדוע Perplexity מצטט דפים של צד שלישי במקום האתר של החברה עצמה?
מערכת האחזור של Perplexity בוחרת מקורות על בסיס רלוונטיות, אמינות ואיכות תוכן לכל שאילתה ספציפית. עבור שאילתות המלצה רחבות, המערכת לרוב מעדיפה מקורות של צד שלישי כגון פלטפורמות ביקורת וסיכומי עריכה, מכיוון שהם מציעים הקשר השוואתי שאתר ספק יחיד אינו ממוקם לספק. עבור שאילתות מוצר ספציפיות, הדפים של הספק עצמו נוטים יותר להיות מצוטטים. כאשר אתר החברה נעקף באופן עקבי, הדבר מצביע לרוב על בעיות במבנה התוכן, גישת הסריקה, עומק התוכן, או המידה שבה הדף מתייחס ישירות לשאילתה הנשאלת.
הבנת המקורות של Perplexity היא הצעד הראשון
התנהגות המקורות של Perplexity אינה שרירותית, אך היא דינמית. המערכת מאחזרת תוכן בזמן אמת ממאגר רחב ומשתנה הכולל מקורות רשת, פלטפורמות ביקורת, דיונים קהילתיים, תיעוד רשמי ושותפי נתונים פרמיום. תמהיל המקורות משתנה בהתאם לסוג השאילתה, רמת המנוי של המשתמש ובחירת מצב המיקוד.
עבור עסקים וספקי תוכנה, השאלה המעשית אינה כיצד לתמרן את המערכת. השאלה היא האם למותג יש תוכן שימושי, מובנה היטב ונגיש במקומות שבהם מערכת האחזור של Perplexity כבר מחפשת — ואם התוכן הזה מתייחס ישירות לשאלות שהקונים מגישים בפועל.
אם אינכם בטוחים היכן המותג שלכם עומד כיום בסביבות חיפוש ה-AI, CiteHarbor יכול לעזור לכם לגלות. אנו מבצעים ביקורות נראות ב-Perplexity, ChatGPT, Gemini, Claude ו-Google AI Overview, חוקרים את שאלות הרוכשים החשובות בקטגוריה שלכם, ומנהלים את מלוא תהליך העבודה של התוכן וההפצה — כך שאינכם צריכים לעשות זאת.
התחילו את תקופת הניסיון החינמית של שבועיים — ללא צורך בכרטיס אשראי.