Quelles sources Perplexity utilise-t-il pour recommander des entreprises ou des logiciels ?
Découvrez comment Perplexity sélectionne ses sources lorsqu'il recommande des entreprises ou des logiciels — des pages web et plateformes d'avis aux forums, à la documentation officielle et aux partenaires de données premium. Cet article explique comment le type de requête et les modes de focus influencent les sources citées.
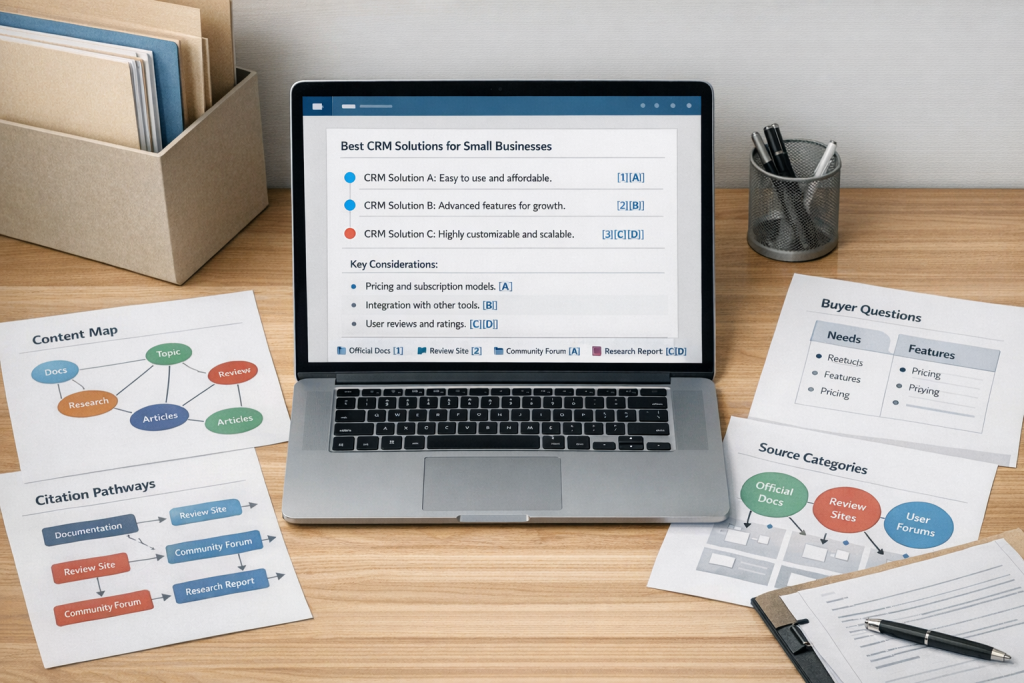
Quelles sources Perplexity utilise-t-il pour recommander des entreprises ou des logiciels ?
Perplexity ne dispose pas d’un répertoire fixe d’entreprises ou de logiciels approuvés. Chaque requête déclenche un processus de récupération en temps réel qui assemble des réponses à partir d’une combinaison changeante de contenu web, de plateformes d’avis, de documentation officielle, de discussions communautaires, et — pour les abonnés Pro et Enterprise — de partenaires de données premium sous licence. Les sources qui apparaissent dans une réponse donnée dépendent de la nature de la question, de la précision de la requête et de ce que le système de récupération juge le plus pertinent à ce moment-là.
Cet article détaille chaque catégorie de sources à partir desquelles Perplexity puise, explique comment le type de requête modifie la composition des sources, présente les modes de recherche ciblée qui permettent aux utilisateurs d’orienter le pool de sources, et examine ce que tout cela signifie pour les entreprises et les éditeurs de logiciels qui cherchent à comprendre leur visibilité dans les réponses générées par l’IA.
Comment Perplexity récupère les sources pour chaque requête
Perplexity fonctionne comme un moteur de réponse plutôt que comme un moteur de recherche traditionnel. Un utilisateur soumet une question et reçoit une réponse synthétisée avec des citations intégrées — et non une liste classée de liens à parcourir. Le système récupère du contenu provenant de tout le web en temps réel, utilise ce contenu pour construire une réponse directe, et relie chaque affirmation à sa source d’origine afin que le lecteur puisse vérifier l’information.
L’approche technique qui sous-tend ce processus est la génération augmentée par récupération, communément abrégée en RAG. En termes pratiques : le modèle de langage sous-jacent ne dépend pas uniquement de ce qu’il a appris lors de son entraînement. Pour chaque requête, il explore le web, extrait le contenu des pages qu’il juge les plus pertinentes et utilise ce matériau récupéré pour façonner la réponse. La réponse est générée à nouveau pour chaque requête, et les sources citées peuvent varier selon ce qui a été récemment publié, ce qui est actuellement accessible et dans quelle mesure une page donnée correspond à la question posée.
C’est pourquoi deux personnes posant des versions légèrement différentes de la même question peuvent recevoir des réponses qui citent des sources entièrement différentes. La récupération est en temps réel et spécifique à la requête, et non extraite d’un cache fixe.
Point clé : Les citations intégrées dans les réponses de Perplexity ne sont pas cosmétiques. Elles représentent la façon dont le système indique quelles pages il a récupérées, évaluées et utilisées comme base pour des parties spécifiques de sa réponse. Chaque lien cité représente une page qui a franchi le seuil de pertinence du système de récupération pour cette requête particulière.
Les principales catégories de sources à partir desquelles Perplexity puise
Perplexity ne fonctionne pas à partir d’une liste de sources approuvées unique. Il puise dans plusieurs catégories de contenu distinctes, et les catégories qui dominent une réponse donnée dépendent de la requête. Comprendre ces catégories est fondamental pour comprendre pourquoi certaines pages apparaissent dans les recommandations de l’IA et d’autres non.
Contenu web général et publications à haute autorité
La plupart des requêtes commencent par le web ouvert. Cela inclut les médias d’information, les publications sectorielles, les synthèses produites par des rédacteurs, les guides longs formats faisant autorité et les propriétés de domaines bien établies. Le système de récupération semble favoriser les pages au contenu substantiel et dense en informations par rapport aux pages principalement promotionnelles ou structurellement légères.
Les tendances observées suggèrent que les pages dotées d’une organisation claire, d’affirmations factuelles précises et d’une autorité thématique démontrée sont récupérées et citées de manière plus constante. Les pages construites autour d’un langage commercial agressif, d’un contenu original minimal ou d’un bourrage de mots-clés ont tendance à être filtrées ou ignorées au profit d’alternatives plus substantielles.
Plateformes d’évaluation et de comparaison de logiciels
Lorsqu’une requête demande à Perplexity de recommander des logiciels — qu’il s’agisse d’outils de gestion de projet, de plateformes CRM, de logiciels de comptabilité ou de toute autre catégorie — le système s’appuie fréquemment sur des plateformes dédiées à l’évaluation et à la comparaison. G2, Capterra et TrustRadius figurent parmi les sources les plus fréquemment observées dans cette catégorie.
Ces plateformes apparaissent car elles regroupent en un seul endroit des avis d’utilisateurs structurés, des comparaisons fonctionnalité par fonctionnalité, des données tarifaires et des classements par catégorie. Pour un système de récupération qui assemble une recommandation de logiciel, ce type de contenu organisé et comparatif est directement utile.
Ce qui est cité depuis ces plateformes n’est souvent pas la page d’accueil. Perplexity extrait régulièrement des pages de catégories spécifiques, des profils de produits individuels, des pages de comparaison directe et des synthèses d’avis — la page qui correspond le plus précisément aux spécificités de la question posée.
Sources officielles des éditeurs et des entreprises
Perplexity cite fréquemment des pages officielles d’entreprises lorsqu’une requête concerne un produit ou une activité spécifique. Les pages produits, les pages de tarification, les centres de documentation, les centres d’aide, les pages « À propos » et les communiqués de presse entrent tous dans cette catégorie.
Ces pages ont tendance à apparaître le plus souvent lorsque la requête est précise et spécifique à un produit — demandant ce qu’une entreprise particulière propose ou comment une fonctionnalité spécifique fonctionne — plutôt que lorsque la requête porte sur une comparaison générale de catégorie. Pour des questions très ouvertes comme « meilleur CRM pour les petites entreprises », Perplexity a tendance à s’appuyer sur des sources tierces. Pour des questions ciblées sur un produit, il est plus probable qu’il se rende directement sur le contenu propre de l’éditeur.
L’implication pratique : si la documentation officielle d’un produit d’une entreprise est obsolète, mal organisée ou structurée de manière à rendre difficile son traitement par les robots d’exploration, Perplexity peut citer une version ancienne de ce contenu, se rabattre sur une description tierce ou contourner entièrement l’entreprise.
Discussions communautaires et forums
Les fils Reddit, les réponses Quora, les forums de développeurs et les communautés de niche apparaissent régulièrement dans les citations Perplexity — en particulier pour les requêtes avec une dimension de sentiment ou d’expérience. Les questions telles que « qu’est-ce que les utilisateurs réels pensent de ce produit », « cet outil vaut-il vraiment son prix » ou « meilleur prestataire de services dans cette ville » font fréquemment remonter des discussions communautaires comme sources principales ou complémentaires.
Le système semble favoriser le contenu communautaire lorsque la nature de la requête indique que l’utilisateur recherche une expérience utilisateur authentique plutôt que des affirmations produites par des fournisseurs. Les marques disposant d’une présence réelle dans les communautés pertinentes — à travers des conversations d’utilisateurs organiques, et non des publications fabriquées — offrent à Perplexity davantage de sources sur lesquelles s’appuyer lorsque ces requêtes axées sur l’expérience arrivent.
L’inverse est également vrai. Une marque sans empreinte significative dans les discussions communautaires peut constater que Perplexity dispose simplement de moins de matière lorsque les utilisateurs posent des questions axées sur l’expérience concernant cette catégorie.
Partenaires de données sous licence premium
Les abonnés Perplexity Pro et Enterprise reçoivent des réponses pouvant s’appuyer sur des sources de données sous licence premium indisponibles sur le Web ouvert. Il s’agit de bases de données de niveau professionnel avec lesquelles Perplexity a établi des partenariats afin d’approfondir la qualité de ses réponses pour les requêtes d’ordre commercial, financier et d’études de marché.
Les partenaires premium confirmés et ce que chacun apporte au corpus de sources :
- PitchBook : Renseignements sur les marchés privés couvrant les données firmographiques, les tours de financement, les profils d’investisseurs et l’activité des transactions. Plus pertinent pour les requêtes portant sur les startups, les entreprises soutenues par le capital-risque et la dynamique des marchés privés.
- CB Insights : Suivi des startups, cartographie des marchés, analyse du paysage concurrentiel et données sur les tendances sectorielles. Plus pertinent pour les requêtes de stratégie d’entreprise et d’études de marché.
- Statista : Statistiques mondiales, chiffres de dimensionnement des marchés, prévisions sectorielles et données d’études consommateurs. Plus pertinent pour les requêtes nécessitant des informations de marché quantifiées.
- IBISWorld : Rapports de recherche sectorielle et analyses des conditions de marché. Plus pertinent pour les requêtes portant sur des secteurs verticaux spécifiques et la dynamique au niveau des filières.
- Dun & Bradstreet : Données de crédit commercial, profils d’entreprises, données firmographiques B2B et évaluation des risques commerciaux. Plus pertinent pour les requêtes portant sur la crédibilité des entreprises, la vérification des fournisseurs et la recherche d’informations sur les sociétés.
- Guidepoint : Accès à des réseaux d’experts et recherche primaire. Plus pertinent pour les requêtes spécialisées bénéficiant d’une perspective de praticien.
- Wiley : Revues académiques et professionnelles, ouvrages de référence en commerce et en STIM. Plus pertinent pour les requêtes nécessitant des sources évaluées par des pairs ou des références académiques.
Ces sources premium apparaissent le plus souvent dans les requêtes B2B entreprise, les demandes de veille concurrentielle, les questions de dimensionnement de marché et la recherche financière. Un utilisateur standard en offre gratuite ne verra pas de réponses enrichies par ces bases de données, ce qui signifie que la composition des sources pour une même question peut varier considérablement selon le niveau d’abonnement de l’utilisateur.
Comment le type de requête modifie la composition des sources
L’un des aspects les plus déterminants et les moins discutés du comportement de Perplexity en matière de sources est que la composition des sources varie sensiblement selon le type de question posée. Une requête sur une entreprise locale, une requête de comparaison de logiciels et une requête de recherche B2B entreprise tendent chacune à s’appuyer sur différentes catégories de sources dans des proportions différentes.
Requêtes sur les entreprises locales
Lorsqu’une personne demande à Perplexity quelle est la meilleure entreprise de climatisation-chauffage dans une ville précise ou la meilleure représentation juridique à proximité, le système tend à s’appuyer sur les plateformes d’avis locaux, les données Google Business Profile, Yelp, les annuaires spécialisés par secteur et les discussions communautaires. Le site web propre d’une entreprise peut apparaître, mais la réponse est généralement ancrée dans des signaux de crédibilité tiers — notes, avis et présence dans les annuaires locaux.
Requêtes de comparaison de logiciels
Une requête demandant le meilleur logiciel de gestion de projet pour une équipe d’une taille précise oriente la composition des sources vers les plateformes d’avis sur les logiciels telles que G2, Capterra et TrustRadius, ainsi que vers des articles de synthèse éditoriaux issus de publications technologiques et la documentation officielle des éditeurs. Les discussions communautaires provenant de Reddit ou de forums de développeurs peuvent également apparaître, notamment lorsque la requête inclut une préférence ou une contrainte que les plateformes d’avis ne traitent pas directement.
Requêtes de recherche B2B entreprise
Une requête portant sur les principaux fournisseurs de cybersécurité pour les entreprises de taille intermédiaire dans les services financiers tend à s’appuyer sur des rapports d’analystes sectoriels, des partenaires de données premium pour les abonnés Pro, des publications économiques et des contenus éditoriaux faisant autorité. Les plateformes d’avis peuvent toujours apparaître, mais la composition des sources s’oriente vers des contenus plus spécialisés et plus approfondis. C’est le type de requête pour lequel les partenaires de données premium comme PitchBook, CB Insights et IBISWorld sont les plus susceptibles de faire partie de la réponse.
La conclusion pratique : Une entreprise cherchant à comprendre sa visibilité sur Perplexity doit réfléchir attentivement au type de requête qu’un acheteur potentiel soumettrait réellement — puis évaluer si la marque dispose de contenus pertinents et accessibles dans les catégories de sources auxquelles Perplexity fait appel pour ce type de requête spécifique.
Les modes de focus et leur contrôle de la sélection des sources
Perplexity donne aux utilisateurs la possibilité de restreindre le corpus de sources pour toute requête grâce aux modes de focus. La sélection d’un mode de focus modifie les catégories de contenus que le système de récupération priorise lors de la construction d’une réponse.
Les modes de focus disponibles sont les suivants :
- Web : Le paramètre par défaut. Récupère à partir de l’ensemble des sources web accessibles au public.
- Academic : Priorise les recherches évaluées par les pairs, les revues académiques et les bases de données universitaires.
- Social : Priorise les plateformes de médias sociaux et les contenus sociaux accessibles au public.
- Reddit : Restreint la récupération spécifiquement aux fils Reddit et aux discussions communautaires.
- YouTube : Priorise les contenus vidéo hébergés sur YouTube.
- Writing : Oriente le modèle vers la génération de texte plutôt que vers la récupération de sources et la citation.
Les modes de focus importent car ils donnent à l’utilisateur un contrôle direct sur le type de source qui façonne la réponse. Une personne effectuant une recherche en mode Reddit pour le meilleur logiciel de comptabilité pour les indépendants recevra une réponse construite entièrement à partir de discussions Reddit. Cela signifie que les produits mentionnés seront ceux qui apparaissent de manière organique dans les conversations Reddit — pas nécessairement ceux qui ont les profils les plus solides sur les plateformes d’avis ou les pages marketing les plus soignées.
Perplexity propose également un mode Deep Research qui élargit le périmètre de récupération. Le mode Deep Research effectue un processus de recherche plus approfondi, s’appuyant sur un éventail plus large de sources et produisant des réponses plus longues et plus détaillées. Pour les requêtes de recommandation d’entreprises et de logiciels, le mode Deep Research tend à faire émerger un éventail de sources plus large — incluant des partenaires de données premium, des contenus académiques et des publications spécialisées de niche qui pourraient ne pas apparaître dans une requête standard.
Ce qui rend une source plus susceptible d’apparaître dans les réponses de Perplexity
Personne en dehors de Perplexity n’a de visibilité sur la manière exacte dont son système de récupération évalue et sélectionne les sources. Mais des tendances constantes observées sur un grand nombre de requêtes indiquent des caractéristiques que les pages fréquemment citées ont tendance à partager.
- Pertinence directe par rapport à la requête : Les pages qui traitent de la question spécifique posée — plutôt que d’un sujet vaguement adjacent — sont citées de manière plus constante. La précision l’emporte sur l’étendue.
- Récence : Pour les sujets où les informations changent régulièrement, comme les fonctionnalités des logiciels, les tarifs ou les détails des entreprises, les pages mises à jour plus récemment semblent être privilégiées par rapport aux contenus plus anciens.
- Accessibilité au robot d’exploration : Perplexity exploite son propre robot d’exploration web. Une page qui bloque ce robot d’exploration ou qui n’est pas rendue en HTML accessible ne peut pas être récupérée ni citée, quelle que soit la qualité de son contenu.
- Densité d’information : Les pages dont le contenu est détaillé et riche en faits sont citées plus souvent que les pages au contenu superficiel, aux textes standardisés ou au langage principalement promotionnel.
- Signaux d’autorité thématique : L’autorité du domaine, la crédibilité éditoriale et l’expertise démontrée sur le sujet spécifique semblent influencer la sélection des sources — bien qu’ici, l’autorité désigne la crédibilité sur le sujet particulier, et non la force globale du domaine.
- Corroboration entre sources : Lorsqu’une affirmation apparaît de manière cohérente sur plusieurs sources, Perplexity semble plus enclin à inclure cette affirmation dans sa réponse et à citer les pages qui la soutiennent.
Il s’agit de tendances dérivées de l’observation, et non de règles internes confirmées. La logique de récupération de Perplexity est propriétaire. Mais ces tendances sont suffisamment cohérentes d’une requête à l’autre pour servir de cadre de travail pratique.
Une distinction importante : Être exploré par le robot d’exploration de Perplexity n’est pas la même chose qu’être cité dans une réponse Perplexity. Une page peut exister dans l’index sans jamais apparaître comme source citée. Une citation requiert que la page soit récupérable et évaluée comme l’une des options les plus pertinentes et crédibles pour une requête spécifique au moment où elle est soumise.
Ce que cela signifie pour les entreprises et les éditeurs de logiciels
Si Perplexity puise dans les plateformes d’avis, les discussions communautaires, la documentation officielle, les publications éditoriales et les partenaires de données premium — et que cette combinaison varie selon le type de requête —, alors une entreprise qui souhaite comprendre sa visibilité dans la recherche par IA doit prendre en compte l’ensemble de ces espaces, et pas seulement son propre site web.
Voici à quoi cela ressemble en pratique :
- La présence sur les plateformes d’avis fait partie de l’équation de visibilité. Lorsque des acheteurs de logiciels demandent des recommandations à Perplexity et que le système s’appuie sur G2 et Capterra, un profil à jour et bien entretenu sur ces plateformes influe directement sur la présence d’une marque dans la réponse.
- L’empreinte communautaire détermine les ressources dont dispose Perplexity. Lorsque Perplexity fait remonter des fils Reddit et des discussions de forums pour des requêtes axées sur l’expérience, les marques disposant d’une présence communautaire authentique offrent au système davantage de matériaux sources à exploiter en leur faveur.
- La documentation officielle doit être accessible et à jour. Si les pages produit, le centre d’aide ou la page de tarification d’une entreprise sont obsolètes, bloqués aux robots d’exploration ou organisés de manière difficile à analyser, Perplexity pourrait les ignorer au profit de descriptions tierces de ce même produit.
- Le contenu conçu autour de véritables questions d’acheteurs se comporte différemment du contenu de blog générique. Une page qui répond directement à une question précise qu’un acheteur pourrait poser — avec une structure claire, des affirmations spécifiques et des preuves à l’appui — est mieux positionnée pour correspondre à la logique de récupération qu’un article de notoriété général rédigé pour remplir un calendrier éditorial.
- La couverture par les données premium est importante pour les marques s’adressant aux entreprises. Lorsque les utilisateurs de Perplexity Pro reçoivent des réponses enrichies par PitchBook, CB Insights ou Dun & Bradstreet, les entreprises B2B doivent comprendre si elles figurent dans ces bases de données.
Rien de tout cela n’est une garantie. Aucune entreprise ne peut contraindre Perplexity à citer une page précise ni à mentionner une marque spécifique dans une recommandation. Mais comprendre quelles catégories de sources le système exploite — et évaluer si une marque dispose d’un contenu pertinent, accessible et crédible dans ces catégories — constitue le fondement de toute stratégie de visibilité IA concrète.
C’est le travail que CiteHarbor réalise pour ses clients. Nous auditons les endroits où une marque apparaît actuellement — et ceux où elle est absente — dans les environnements de recherche IA, notamment Perplexity, ChatGPT, Gemini, Claude et Google AI Overview. Nous étudions les questions d’acheteurs qui orientent les recommandations dans la catégorie du client. Nous produisons du contenu conçu pour répondre à ces questions avec la structure, la précision et la profondeur que les systèmes de récupération IA ont tendance à mettre en avant. Et nous gérons l’exécution complète — publication sur WordPress, diffusion sur les réseaux sociaux, suivi des citations mensuelles, surveillance de la visibilité des concurrents et fourniture de rapports de performance brandés — afin que le client n’ait pas à gérer une plateforme supplémentaire ni un flux de travail additionnel.
L’objectif n’est pas de manipuler un moteur IA. L’objectif est de s’assurer que la marque dispose d’un contenu utile, trouvable et bien structuré dans les endroits où les systèmes IA cherchent déjà.
Questions fréquemment posées
Perplexity utilise-t-il Google ou Bing pour trouver des sources ?
Oui. Perplexity utilise plusieurs API de recherche, dont Google et Bing, en complément de son propre robot d’exploration propriétaire. Les résultats issus de ces entrées sont combinés pour constituer le pool de sources de chaque requête. Le système ne se limite pas à l’index d’un seul moteur de recherche.
Perplexity utilise-t-il des sources fiables ?
Perplexity applique une logique de filtrage qui semble favoriser les contenus denses en informations, objectifs et faisant autorité, par rapport aux pages superficielles ou fortement promotionnelles. Le système de citation intégré ajoute une couche de transparence — chaque source citée est directement liée dans la réponse, afin que le lecteur puisse l’évaluer de manière indépendante. Cela dit, aucun système de récupération n’est infaillible, et les lecteurs doivent évaluer les sources citées selon leurs propres critères.
Quelle est la différence entre les sources gratuites et premium de Perplexity ?
Les réponses de l’offre gratuite s’appuient sur des contenus web accessibles au public — sites web, plateformes d’avis, forums, médias d’information et publications éditoriales. Les abonnés Pro et Enterprise reçoivent des réponses pouvant s’appuyer sur des partenaires de données premium sous licence, notamment PitchBook, CB Insights, Statista, IBISWorld, Dun & Bradstreet, Guidepoint et Wiley. Ces sources premium apportent une profondeur supplémentaire pour les requêtes portant sur les domaines des affaires, de la finance et de l’étude de marché que le web ouvert seul ne peut pas pleinement satisfaire.
Les entreprises peuvent-elles influencer le fait que Perplexity les recommande ?
Aucune entreprise ne peut imposer une citation. En revanche, les entreprises peuvent améliorer leurs chances d’être accessibles à la récupération en maintenant un contenu actuel et bien structuré dans les catégories de sources exploitées par Perplexity — notamment leur propre site web, les plateformes d’avis pertinentes, les discussions communautaires et les publications sectorielles. L’objectif est d’être présent, accessible et véritablement utile dans les endroits où le système de récupération de Perplexity recherche de l’information.
Perplexity doit-il disposer de son propre plan de contenu et de prompt distinct du SEO ?
Pas nécessairement un plan entièrement distinct, mais une extension délibérée de la stratégie de contenu existante. Les qualités qui rendent une page utile au système de récupération de Perplexity — structure claire, réponses directes à de vraies questions, profondeur substantielle, accès d’exploration — recoupent de manière significative les bonnes pratiques SEO. La différence tient à l’emphase : les systèmes de récupération par IA tendent à privilégier les réponses concises et extractibles ainsi que les sections bien organisées, tandis que le SEO traditionnel peut favoriser des approches de contenu plus larges. La plupart des entreprises ont tout intérêt à intégrer la réflexion sur la visibilité IA dans leur flux de travail de contenu existant, plutôt que de la traiter comme un programme distinct à gérer.
Pourquoi Perplexity cite-t-il des pages tierces plutôt que le site web de l’entreprise elle-même ?
Le système de récupération de Perplexity sélectionne les sources en fonction de la pertinence, de la crédibilité et de la qualité du contenu pour chaque requête spécifique. Pour les requêtes de recommandation générales, le système favorise souvent des sources tierces telles que les plateformes d’avis et les sélections éditoriales, car elles offrent un contexte comparatif qu’un site web de fournisseur unique n’est pas en mesure de proposer. Pour les requêtes portant sur des produits spécifiques, les pages propres au fournisseur ont davantage de chances d’être citées. Lorsque le site web d’une entreprise est systématiquement écarté, cela pointe souvent vers des problèmes de structure de contenu, d’accès d’exploration, de profondeur du contenu ou du degré auquel la page répond directement à la requête posée.
Comprendre les sources de Perplexity est la première étape
Le comportement de Perplexity en matière de sources n’est pas arbitraire, mais il est dynamique. Le système récupère du contenu en temps réel à partir d’un ensemble vaste et évolutif qui comprend des sources web, des plateformes d’avis, des discussions communautaires, de la documentation officielle et des partenaires de données premium. La composition des sources varie selon le type de requête, le niveau d’abonnement de l’utilisateur et la sélection du mode de focus.
Pour les entreprises et les éditeurs de logiciels, la question pratique n’est pas de savoir comment manipuler le système. Il s’agit de déterminer si la marque dispose d’un contenu utile, bien structuré et accessible dans les endroits où le système de récupération de Perplexity cherche déjà — et si ce contenu répond directement aux questions que les acheteurs soumettent réellement.
Si vous ne savez pas où se situe actuellement votre marque dans les environnements de recherche IA, CiteHarbor peut vous aider à le découvrir. Nous réalisons des audits de visibilité sur Perplexity, ChatGPT, Gemini, Claude et Google AI Overview, explorons les questions d’acheteurs qui comptent dans votre catégorie, et gérons l’intégralité du flux de travail de contenu et de distribution pour que vous n’ayez pas à le faire.
Commencez votre essai gratuit de 2 semaines — aucune carte bancaire requise.