Avez-vous besoin d’une stratégie de contenu distincte pour la visibilité sur Perplexity ?
Vous n'avez pas besoin d'une stratégie de contenu distincte pour Perplexity, mais vous devez adapter la façon dont vous structurez, actualisez et attribuez votre contenu en vue des citations dans la recherche par IA. Cet article explique ce qui se transpose depuis le SEO, ce qui doit évoluer et comment mesurer votre visibilité dans la durée.
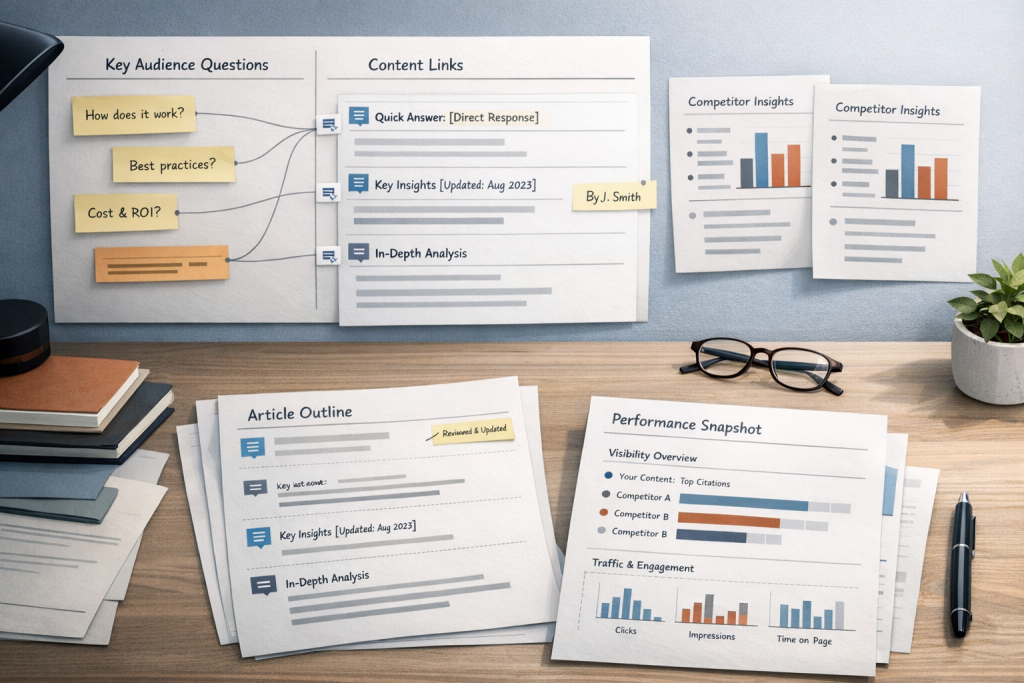
Avez-vous besoin d’une stratégie de contenu distincte pour la visibilité sur Perplexity ?
La réponse courte est non — une refonte complète n’est pas ce que Perplexity exige. Ce qu’il exige, en revanche, c’est une compréhension claire des points de divergence entre Perplexity et Google, car ces divergences ont des conséquences réelles sur la façon dont vous structurez votre contenu, la fréquence à laquelle vous le mettez à jour, et la clarté avec laquelle vous signalez l’expertise qui le sous-tend. La majorité d’un programme SEO bien géré se transpose sans modification. L’écart entre le contenu destiné à la recherche traditionnelle et le contenu prêt pour Perplexity est réel, mais plus étroit que ne le laissent entendre les discussions du secteur — et c’est précisément pourquoi des marques bien positionnées sur Google ne sont parfois jamais citées dans les réponses de Perplexity.
Cet article passe en revue ce qui se transfère depuis votre programme existant, ce qui nécessite des ajustements délibérés, et comment mesurer si ces ajustements produisent des résultats. Si vous êtes directeur marketing (CMO), directeur SEO, responsable de contenu ou responsable marketing produit avec un investissement actif dans la recherche, voici l’analyse opérationnelle à lire avant de vous engager dans une nouvelle direction.
Comment Perplexity récupère le contenu différemment de Google
La question n’a de pertinence que parce que Perplexity fonctionne selon un modèle de récupération fondamentalement différent de celui de Google. Comprendre correctement ces mécanismes est le moyen le plus rapide de saisir ce qui doit réellement changer.
Récupération en temps réel plutôt que classements préconstruits
Le modèle de Google est bien connu : il explore le web en continu, construit un index persistant et évalue les pages par rapport aux requêtes entrantes en utilisant des signaux incluant l’autorité des liens, la pertinence et des centaines d’autres facteurs. La recherche d’un utilisateur renvoie une liste classée extraite de cet index préexistant.
Perplexity fonctionne différemment au niveau structurel. Chaque fois qu’un utilisateur soumet une question, Perplexity interroge le web en direct, extrait du contenu de plusieurs sources à ce moment-là, synthétise une réponse et met en avant les sources dont il s’est servi. Il n’existe aucune liste préclassée en attente d’être servie. Votre contenu est évalué au moment de la requête — et non lors d’une exploration qui a eu lieu la semaine précédente.
La conséquence pratique : la fraîcheur, la clarté et l’accessibilité structurelle ont un poids plus immédiat que dans la recherche traditionnelle.
Comment PerplexityBot traite vos pages
Perplexity exploite son propre robot d’exploration, PerplexityBot, pour récupérer du contenu sur l’ensemble du web. Là où Google évalue une page de manière globale en tant que document classable, PerplexityBot aborde les pages différemment — il segmente le contenu en sections distinctes et évalue si chaque segment contient des réponses directes et extractibles à la question posée.
L’implication que la plupart des programmes de contenu négligent : une page peut être réellement bien rédigée et ne produire aucune citation Perplexity si ses sections ne sont pas suffisamment cohérentes de manière autonome pour être extraites et attribuées indépendamment. Chaque section principale doit être capable de fonctionner comme une unité de réponse autonome, et non simplement comme un élément de soutien au sein d’un argument plus long.
Les dates de publication comme signal de confiance visible
Lorsque Perplexity cite une source, il affiche fréquemment la date de publication ou de mise à jour de cette source aux côtés de la citation — visible par l’utilisateur final, et non enfouie dans les métadonnées. Cela semble influencer la sélection des sources lorsque plusieurs pages traitent la même question. Une page ayant fait l’objet d’une mise à jour récente et substantielle a tendance à avoir plus de poids qu’une page plus ancienne restée inchangée, même lorsque cette dernière bénéficie d’une autorité de liens externes plus solide.
Pour les équipes de contenu, cela repositionne la fraîcheur du contenu : non plus comme une simple tâche d’hygiène de référencement, mais comme un signal de crédibilité visible que les utilisateurs peuvent voir et évaluer eux-mêmes.
Ce qui se transfère directement depuis votre programme SEO existant
Un programme SEO ou de contenu fonctionnel génère déjà une valeur significative pertinente pour Perplexity. Voici ce qui s’applique sans modification.
Autorité établie et signaux de liens
Perplexity puise dans le web ouvert, et les pages disposant d’une autorité réelle — construite grâce à des citations externes, une publication régulière et la reconnaissance de sources faisant autorité — ont tendance à apparaître plus fiablement que les pages peu étoffées ou récemment créées sans historique externe. L’autorité que votre programme a déjà construite constitue un atout actif.
Profondeur thématique et couverture du contenu
Si votre programme de contenu a développé des clusters autour de domaines thématiques principaux — abordant un sujet sous plusieurs angles, avec des contenus interliés qui se renforcent mutuellement — cette profondeur est transférable. La récupération de Perplexity tend à privilégier les sources qui démontrent un engagement soutenu et substantiel envers un sujet, plutôt que les sites qui l’abordent une seule fois dans un article superficiel.
Accessibilité technique
Un site techniquement sain pour Google — HTML propre, performances de chargement raisonnables, liens internes fonctionnels, configuration canonique précise — est généralement accessible à PerplexityBot également. Un point mérite vérification : les contenus qui reposent fortement sur le rendu JavaScript côté client ou qui se trouvent dans des PDF peuvent ne pas être aussi fiablement accessibles à PerplexityBot qu’à Googlebot. Le contenu principal doit être disponible en HTML standard, explorable par les robots d’exploration.
Il est également utile de vérifier que votre fichier robots.txt ne restreint pas l’accès d’exploration à PerplexityBot. Un robot d’exploration bloqué signifie aucune citation, quelle que soit la qualité du contenu.
Mise en forme déjà optimisée pour les réponses directes
Un contenu structuré pour les featured snippets de Google — avec des hiérarchies de titres claires, des paragraphes concis, des listes à puces et des réponses placées en tête de section — se traduit directement dans le modèle d’extraction de Perplexity. Si votre équipe a déjà investi dans ce type de discipline de mise en forme, vous ne partez pas de zéro.
Ce qui doit spécifiquement changer
C’est là que réside le travail de fond. Il ne s’agit pas d’ajustements cosmétiques — mais il ne s’agit pas non plus d’un remplacement en bloc de votre stratégie. Les ignorer est l’explication la plus courante pour laquelle des marques disposant de solides programmes SEO n’apparaissent toujours pas dans les réponses de Perplexity.
Commencer par la réponse : structurer pour l’extraction, pas pour la construction narrative
Le contenu SEO long format traditionnel construit souvent vers une conclusion — le contexte d’abord, la réponse ensuite. Le modèle de découpage de Perplexity inverse cette priorité. Les phrases d’ouverture de chaque section ont un poids considérable, car c’est ce que PerplexityBot est le plus susceptible d’extraire comme bloc de réponse autonome. Une réponse enfouie dans le quatrième paragraphe d’une section de sept paragraphes peut ne pas être récupérée du tout.
L’ajustement requis : ouvrez chaque section principale avec la réponse directe ou l’affirmation centrale, puis développez le contexte de soutien en dessous. Il ne s’agit pas de simplifier votre contenu — il s’agit de placer la substance là où le système de récupération peut la trouver.
Traiter la fraîcheur comme un engagement éditorial permanent
La plupart des programmes SEO abordent les mises à jour de contenu de manière réactive — en revisitant les pages lorsque les classements chutent ou que le trafic diminue. Pour la visibilité sur Perplexity, la fraîcheur doit être une discipline proactive et planifiée plutôt qu’une réponse de maintenance.
Cela ne signifie pas modifier les dates de publication sans changer le contenu sous-jacent. Cela signifie intégrer des cycles de révision réguliers dans votre calendrier éditorial — en vérifiant que les informations sont à jour, que les exemples sont toujours pertinents et que la date de mise à jour visible reflète un vrai travail éditorial. Parce que Perplexity affiche ces dates aux utilisateurs, un horodatage obsolète à côté de la page récemment révisée d’un concurrent crée un désavantage immédiat en matière de crédibilité.
Clarté des entités : établir qui parle et pourquoi cela compte
Le cadre E-E-A-T de Google — expérience, expertise, caractère faisant autorité, fiabilité — façonne depuis longtemps la manière dont la qualité est évaluée dans les résultats de recherche. Perplexity semble pondérer des signaux analogues, avec une attention particulière portée à la clarté des entités : la capacité du système à identifier qui a produit un contenu et pourquoi cette source fait autorité sur le sujet.
En pratique, cela signifie :
- Une attribution nominative de l’auteur sur les articles, liée à des pages d’auteur qui établissent les qualifications pertinentes
- Un schéma Organization qui identifie clairement votre entreprise dans les données structurées
- Un schéma Person pour les contributeurs individuels, le cas échéant
- Utilisation cohérente du nom de votre organisation et des experts nommés tout au long de votre contenu
Un contenu qui pourrait vraisemblablement avoir été publié par n’importe quelle source anonyme donne moins de raisons à Perplexity de le sélectionner plutôt qu’un concurrent bénéficiant d’une attribution plus claire.
Cibler les questions que les acheteurs posent réellement
La recherche de mots-clés conventionnelle est construite autour de phrases de recherche et de données de volume. Les utilisateurs de Perplexity ont tendance à soumettre des questions sous une forme complète, conversationnelle, souvent en plusieurs parties — le type de requêtes spécifiques, à l’étape de décision, que les outils de mots-clés sous-évaluent ou manquent entièrement.
Une planification de contenu efficace pour Perplexity nécessite d’identifier les questions réelles que posent vos acheteurs à différentes étapes de l’évaluation — notamment les questions de comparaison, les questions de suivi et les questions qui surgissent juste avant une décision d’achat. Cette recherche de questions d’acheteurs diffère de la recherche de mots-clés tant dans la méthode que dans la portée, et elle produit une feuille de route de contenu significativement différente.
Créer un contenu qui mérite d’être cité
Parce que Perplexity cite ses sources, il choisit activement à quelle source attribuer chaque affirmation. Les pages qui proposent des informations spécifiques, vérifiables et clairement attribuées ont plus de chances d’être sélectionnées que les pages qui reformulent des connaissances communes sans apporter quoi que ce soit de distinct.
Un test utile : pour toute affirmation que fait votre contenu, demandez-vous si elle est suffisamment concrète et spécifique pour être citée directement. Les assertions vagues sur les tendances du secteur ne sont pas citables. Les descriptions précises du fonctionnement d’un système, de ce qu’exige un processus ou de ce qu’implique une décision le sont. La spécificité et l’attribution claire sont ce qui distingue une source citable d’un contenu de remplissage qui se perd dans la synthèse.
Le changement fondamental dans la façon dont vous pensez la visibilité
Les ajustements tactiques présentés ci-dessus sont importants, mais ils découlent d’un changement d’orientation plus fondamental.
Le SEO traditionnel demande : Comment faire en sorte que cette page se classe pour ce mot-clé ?
La visibilité à la manière de Perplexity demande : Ma marque est-elle le type de source que ce système va découvrir, approuver et citer lorsqu’une question pertinente lui parvient ?
Ce n’est pas une différence sémantique. Cela change ce que vous construisez et ce que vous mesurez. Le modèle de classement optimise les pages individuelles pour des requêtes individuelles. Le modèle de citation construit un corpus de contenu qui établit votre organisation comme une autorité crédible et citable dans l’ensemble des questions que posent vos acheteurs.
Cette réorientation ne remplace pas le SEO. Elle fonctionne en parallèle. Mais elle fait évoluer les priorités de planification du contenu — les sujets que vous traitez, la façon dont vous structurez ce que vous publiez et ce qui constitue un résultat significatif.
Comment savoir si cela fonctionne : mesurer la visibilité sur Perplexity
La plupart des conseils sur l’optimisation pour Perplexity s’arrêtent avant d’aborder la mesure. Ajuster votre contenu n’est utile que si vous pouvez déterminer si ces ajustements produisent des résultats.
Ce qu’il faut suivre
- Fréquence de citation de la marque dans les réponses générées par l’IA : À quelle fréquence votre organisation apparaît-elle lorsque Perplexity répond aux questions de votre catégorie ? Il s’agit de votre référence de visibilité de base.
- Tendances de citation des concurrents : Quels concurrents sont cités pour les mêmes questions d’acheteurs là où votre marque est absente ? Où apparaissent-ils précisément et pas vous ?
- Trafic de référence provenant des plateformes d’IA : Lorsque Perplexity renvoie vers votre contenu en tant que source citée, ce trafic est mesurable dans vos outils d’analyse. Suivez-le comme un canal distinct.
- Couverture des questions d’acheteurs : Parmi les questions les plus pertinentes pour les décisions de vos acheteurs, combien votre contenu répond-il avec suffisamment de clarté et de directivité pour être extractible ?
Audit de votre contenu existant pour la compatibilité avec Perplexity
Un audit de départ pratique évalue vos pages à plus haute valeur ajoutée selon les critères suivants :
- Chaque section principale s’ouvre-t-elle sur une réponse directe plutôt que d’y conduire progressivement ?
- Les sections individuelles sont-elles suffisamment cohérentes pour être extraites et citées sans contexte environnant ?
- Une date de publication ou de mise à jour substantielle est-elle visible sur la page et suffisamment récente ?
- Y a-t-il une attribution claire à un auteur ou à une organisation ?
- La page utilise-t-elle des données structurées précises — schémas Article, Organization ou Person selon le cas ?
- Le contenu principal est-il rendu en HTML explorable plutôt qu’en JavaScript ou dans des PDF intégrés ?
- Le fichier robots.txt autorise-t-il l’accès d’exploration à PerplexityBot ?
Une page qui échoue à plus de deux de ces vérifications a peu de chances d’obtenir des citations Perplexity, quel que soit son classement dans Google.
Établir une cadence de surveillance
Le comportement de citation de Perplexity n’est pas figé. À mesure que de nouveaux contenus apparaissent sur le Web et que le système continue d’évoluer, les sources citées — et pour quelles questions — évoluent avec le temps. Une surveillance mensuelle constitue un minimum pratique : suivre la présence de votre marque dans les citations en regard d’un ensemble cohérent de questions d’acheteurs, comparer avec les concurrents et identifier les lacunes émergentes avant qu’elles ne s’accumulent.
Il ne s’agit pas d’un audit ponctuel. C’est une boucle de rétroaction récurrente qui oriente à la fois la production de contenu et les priorités de mise à jour.
Pourquoi la réalité opérationnelle est plus difficile que le concept
Les ajustements décrits ci-dessus ne sont pas conceptuellement compliqués. La difficulté réside dans leur exécution à grande échelle, maintenue dans la durée.
La recherche de questions d’acheteurs n’est pas une livraison ponctuelle — elle nécessite une mise à jour continue à mesure que les questions de votre marché évoluent sur plusieurs plateformes d’IA. La restructuration du contenu implique de revisiter les pages existantes, et pas seulement d’en produire de nouvelles. La gestion de la fraîcheur requiert une discipline de calendrier éditorial s’ajoutant aux engagements de production existants. Le travail sur les signaux d’entités implique des données structurées et des pages d’auteur que la plupart des équipes de contenu ne maintiennent pas activement. Le suivi des citations nécessite une surveillance mensuelle des plateformes d’IA avec une régularité suffisante pour faire émerger des tendances significatives.
Pour les équipes qui gèrent déjà le SEO, les médias payants, les réseaux sociaux et la production de contenu, intégrer cela comme un flux de travail interne supplémentaire signifie généralement qu’il est déprioritisé ou exécuté de façon incohérente.
C’est le problème opérationnel que CiteHarbor a été conçu pour résoudre. CiteHarbor gère l’intégralité du flux de travail — de l’audit de visibilité IA et de la recherche de questions d’acheteurs jusqu’à la création d’articles, la publication WordPress, la distribution sur les réseaux sociaux, la surveillance des citations des concurrents et les rapports mensuels de performance à la marque — afin que votre équipe n’ait pas à gérer un autre tableau de bord, un autre calendrier de contenu ou une autre liste de freelances. Le résultat est un instantané mensuel clair de la position de votre marque, livré sous forme de PDF à la marque plutôt qu’une connexion à une nouvelle plateforme.
Une séquence de démarrage pratique
Si vous évaluez la manière d’adapter votre approche de contenu pour Perplexity, voici un ordre d’opérations réaliste :
- Établissez votre référence de visibilité actuelle. Soumettez les questions que posent vos acheteurs directement à Perplexity. Documentez où votre marque apparaît, où apparaissent vos concurrents, et où personne dans votre catégorie n’apparaît du tout.
- Identifiez vos questions d’acheteurs à plus haute valeur. Priorisez les questions liées à des décisions d’achat actives plutôt que les requêtes informationnelles à fort volume de recherche mais à faible intention commerciale.
- Évaluez le contenu existant par rapport aux critères de préparation à Perplexity. Utilisez la liste de contrôle d’audit ci-dessus pour identifier les pages nécessitant une révision structurelle et celles nécessitant des mises à jour de contenu substantielles.
- Restructurez les pages prioritaires. Ouvrez les sections avec des réponses directes. Ajoutez des signaux d’entités. Vérifiez l’exactitude des données structurées. Confirmez que PerplexityBot peut accéder à la page.
- Intégrez une cadence de fraîcheur dans votre calendrier éditorial. Déterminez quelles pages nécessitent une révision régulière et planifiez ce travail explicitement plutôt que de le laisser à une maintenance réactive.
- Commencez le suivi mensuel. Surveillez les citations de votre marque, la visibilité des concurrents et le trafic de référence des plateformes d’IA. Mesurez par rapport à votre référence et ajustez en fonction de vos résultats.
Il s’agit d’une discipline opérationnelle durable, et non d’un projet ponctuel. Les organisations qui développent cette compétence — en interne ou via un partenaire dédié à service complet — accumulent un avantage cumulatif à mesure que l’adoption de la recherche par IA continue de croître.
Foire aux questions
L’optimisation pour Perplexity est-elle différente du référencement Google ?
En partie. Les principes fondamentaux — profondeur du contenu, clarté, autorité et accessibilité technique — s’appliquent aux deux. Les différences significatives résident dans la façon dont le contenu doit être structuré pour en faciliter l’extraction, dans la fréquence à laquelle il doit être actualisé, et dans le poids accordé aux signaux d’entité et d’attribution. La formulation la plus juste est que l’optimisation pour Perplexity constitue une couche stratégique venant s’ajouter au référencement, et non un substitut à celui-ci.
Mon contenu SEO existant fonctionne-t-il pour Perplexity ?
Une partie est susceptible de fonctionner — notamment le contenu bien structuré, récemment mis à jour, clairement attribué et techniquement accessible aux robots d’exploration. Un contenu bien classé sur Google peut néanmoins rester invisible sur Perplexity si les réponses sont enfouies dans de longues sections, si les dates de publication sont absentes ou obsolètes, ou si PerplexityBot ne peut pas accéder à la page.
Qu’est-ce que PerplexityBot ?
PerplexityBot est le robot d’exploration que Perplexity utilise pour récupérer du contenu depuis les sites web. Son fonctionnement est similaire à celui de Googlebot en ce sens qu’il explore les pages du web ouvert, mais il évalue le contenu différemment — en privilégiant les sections discrètes et extractibles plutôt que le classement global au niveau de la page. Si votre fichier robots.txt bloque PerplexityBot, votre contenu n’apparaîtra pas dans les réponses de Perplexity, quelle que soit sa qualité ou son autorité.
Comment savoir si Perplexity cite mon contenu ?
Vous pouvez vérifier manuellement en soumettant les questions d’acheteurs les plus pertinentes pour votre activité et en examinant les sources que Perplexity cite dans ses réponses. Un suivi systématique nécessite un processus reproductible — suivre la présence de votre marque dans les citations sur un ensemble stable de requêtes dans le temps et comparer avec vos concurrents. Le suivi des citations est l’un des composants essentiels du service de suivi mensuel de la visibilité de CiteHarbor.
Ai-je besoin d’un contenu différent pour Perplexity et pour ChatGPT ?
Pas entièrement différent, mais l’accent varie selon la plateforme. Perplexity interroge le web en temps réel pour chaque réponse. Le modèle de base de ChatGPT s’appuie sur des données d’entraînement, bien que ChatGPT Search effectue également une récupération en direct. Les deux valorisent un contenu bien structuré, faisant autorité et clairement attribué — mais Perplexity accorde un poids plus visible à la fraîcheur et à l’attribution des sources. Un programme de visibilité IA bien conçu répond aux deux exigences sans nécessiter des inventaires de contenu distincts pour chaque plateforme.
À quelle fréquence dois-je mettre à jour mon contenu pour la visibilité sur Perplexity ?
Il n’existe pas de règle universelle, mais un standard de travail raisonnable est le suivant : aussi souvent que les informations sous-jacentes changent de manière significative, et au minimum trimestriellement pour vos pages les plus prioritaires. Les mises à jour doivent refléter un véritable travail éditorial — informations révisées, exemples actuels, données actualisées — plutôt que de simples ajustements cosmétiques de date. Parce que Perplexity affiche les dates de mise à jour aux utilisateurs, un horodatage récent associé à un contenu substantiellement à jour crée un avantage de crédibilité notable par rapport aux concurrents dont les pages sont obsolètes.
Qu’est-ce que le GEO et est-ce la même chose que l’optimisation pour Perplexity ?
GEO — Generative Engine Optimization — désigne la pratique plus large consistant à structurer le contenu pour améliorer la visibilité dans les moteurs de recherche et les systèmes de réponse alimentés par l’IA. L’optimisation pour Perplexity s’inscrit dans la catégorie GEO, aux côtés de l’optimisation pour ChatGPT, Google Gemini, Claude et Google AI Overviews. Les principes sous-jacents se recoupent considérablement sur ces plateformes, bien que chacune présente des caractéristiques comportementales qui méritent d’être comprises individuellement.
La version courte
Vous n’avez pas besoin d’une stratégie de contenu distincte pour Perplexity. Vous avez besoin d’une version plus précise de la stratégie que vous avez déjà — une qui tient compte de la façon dont les moteurs de réponse à l’IA récupèrent, évaluent et attribuent le contenu différemment de la recherche traditionnelle. Les ajustements nécessaires sont spécifiques : placement des réponses, discipline de fraîcheur, signaux d’entité, ciblage des questions d’acheteurs et spécificité citable. Les résultats sont mesurables : fréquence de citation de la marque, écarts de visibilité par rapport aux concurrents et trafic de référence provenant des plateformes IA. Le défi opérationnel est réel : ce travail nécessite une exécution cohérente dans les domaines de la recherche, du contenu, de la publication, du suivi et du reporting.
Si votre équipe est déjà sollicitée entre le SEO, les médias payants et la production de contenu, intégrer la visibilité IA comme un flux de travail interne supplémentaire n’est souvent pas réaliste. CiteHarbor a été conçu spécifiquement pour cette situation — gérant l’exécution complète afin que vous receviez un rapport mensuel de performance à votre image de marque plutôt qu’une nouvelle plateforme sur laquelle vous connecter.
Commencez votre essai gratuit de 2 semaines — aucune carte de crédit requise.