כיצד משווקי מוצרים יכולים לעקוב אחר אזכורי מתחרים בהשוואות של ChatGPT ו-Perplexity
למדו כיצד משווקי מוצרים יכולים לנטר אזכורי מתחרים בהשוואות שנוצרות על ידי בינה מלאכותית, לאסוף את נתוני התגובה הנכונים, ולהפוך את הממצאים להחלטות תוכן ומיצוב.
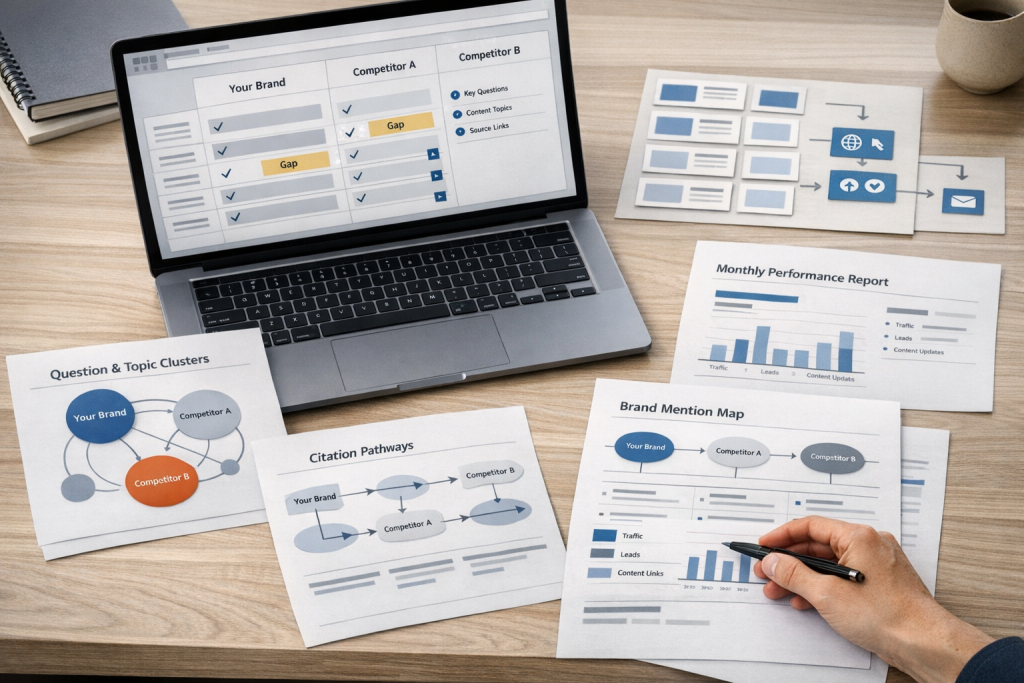
כיצד משווקי מוצרים יכולים לעקוב אחר אזכורי מתחרים בהשוואות ChatGPT ו-Perplexity
משווקי מוצרים יכולים לעקוב אחר אזכורי מתחרים ב-ChatGPT וב-Perplexity על ידי בניית סט עקבי של פרומפטים המבוססים על כוונת רכישה, הפעלתם בלוח זמנים קבוע בשתי הפלטפורמות, תיעוד נתוני התגובה המלאים לכל שאילתה, וחישוב מדדים תחרותיים כגון נתח קול ב-AI ונטישת מתחרים. המטרה אינה רק לאשר שמתחרה מופיע — אלא להבין אילו שאלות קונים מעוררות את ההמלצות שלהם, איזו נרטיב ה-AI בונה סביבם, ואילו מקורות חיצוניים מניעים את הנרטיב הזה.
זה חשוב עכשיו מפני שדירוגי המילות המפתח הקיימים שלכם, הנוכחות באתרי הביקורות ודפי המוצר אינם מספיקים. כאשר קונה שואל את ChatGPT או Perplexity להשוות פתרונות בקטגוריה שלכם, אותן מערכות מייצרות תשובה משלהן — לעיתים קרובות שואבות ממקורות ומסגרות שאינכם יכולים לראות בדוח SERP מסורתי. אם המתחרים שלכם מופיעים בתשובות הללו ואתם לא, יש לכם פער נראות שאף כמות של דירוג Google לא תסגור.
מדריך זה עובר על התהליך המלא: כיצד לבנות את הפרומפטים הנכונים, אילו נתונים ללכוד, אילו מדדים לחשב, כיצד לפרש את הממצאים, וכיצד לחבר את התוצאות להחלטות תוכן ומיצוב שמשפרות בפועל את סיכוייכם להופיע.
מדוע שאילתות השוואה ב-AI הן הרגע בעל הסיכון הגבוה ביותר עבור משווקי מוצרים
כאשר קונה מקליד “best project management tools for remote teams” או “alternatives to [Competitor X]” ב-ChatGPT או ב-Perplexity, הוא אינו גולש. הוא מעריך באופן פעיל. פרומפטים מסוג השוואה אלה יושבים בחלק הצר ביותר של משפך ההתנהלות — ומערכות AI מייצרות כעת תשובות מובנות ובעלות דעה לגביהם.
אינטליגנציה תחרותית מסורתית מכסה דוחות אנליסטים, ביקורות G2, נתח קול של מילות מפתח ואזכורים חברתיים. מה שהיא בדרך כלל אינה מכסה הוא האם תשובות שנוצרו על ידי AI ממליצות על המתחרים שלכם, מתארות את המוצר שלכם בדייקנות, או משאירות את המותג שלכם מחוץ לשיחה לחלוטין.
הפער הזה הוא הבעיה. ועבור רוב צוותי שיווק המוצרים, הוא בלתי נראה — מפני שאף אחד אינו בודק באופן שיטתי.
שלב 1: בניית ספריית פרומפטים לקונים המתמקדת בשאילתות תחרותיות
המעקב מתחיל בידיעת מה לשאול. אתם זקוקים לסט קבוע ויציב של פרומפטים המשקפים את השאלות האמיתיות שהקונים שלכם משתמשים בהן בעת הערכת פתרונות. לא שאלות היפותטיות — שפת קונים אמיתית.
שש קטגוריות הפרומפטים שמשווקי מוצרים זקוקים להן
- שאילתות קטגוריה ומונחי ראש: “Best [category] software for [use case]” או “Top [category] tools in 2025”
- שאילתות מבוססות בעיה: “How do I solve [specific pain point] for my team?”
- שאילתות השוואה ישירה: “[Product A] vs [Product B]” או “Compare [Product A] and [Product B] for [use case]”
- שאילתות חלופה ומעבר: “Best alternatives to [Competitor]” או “What should I use instead of [Competitor]?”
- שאילתות חסרונות ובעיות: “Problems with [Competitor]” או “Why do people leave [Competitor]?”
- שאילתות המלצה: “What [category] tool would you recommend for a [company size/type]?”
שאילתות השוואה וחלופה הן בעלות העדיפות הגבוהה ביותר. אלו הן הפרומפטים שבהם מערכות AI מייצרות את התשובות הישירות והדעתניות ביותר מותג מול מותג — ושבהם היעדרותכם נראית ביותר לקונה המוכן לקבל החלטה.
כיצד לאסוף פרומפטים מהתנהגות קונים אמיתית
הטעות הגדולה ביותר שצוותים עושים היא לנחש מה קונים שואלים. במקום זאת, שאבו פרומפטים ממקורות שבהם שפת הקונים כבר מתועדת:
- תמלולי שיחות מכירה: חפשו את הניסוח המדויק שבו לקוחות פוטנציאליים משתמשים כשהם מתארים מה הם משווים או איזו בעיה הם מנסים לפתור.
- שיחות תמיכת לקוחות: שאלות על תכונות, אינטגרציות ומגבלות משקפות לעיתים קרובות את שאילתות ההשוואה שקונים שואלים לפני רכישה.
- נתוני Google Search Console: סננו לפי שאילתות המכילות שמות מתחרים, “vs,” “alternative,” “compare,” או “best.”
- שאלות באתרי ביקורות: שרשורי דיון ב-G2, Capterra ו-TrustRadius חושפים את השפה שמעריכים אמיתיים משתמשים בה.
- תגובות ייחוס לאחר רכישה: כאשר קונים מזכירים שחיפשו או שאלו עוזר AI לפני שמצאו אתכם, שאלו אותם מה הם בדיוק הקלידו.
כמה פרומפטים, וכיצד לתעדף
התחילו עם 30 עד 50 פרומפטים. הטו את הסט לכיוון שאילתות השוואה וחלופה — אלו הן המקומות שבהם נראות תחרותית חשובה ביותר. שמרו על יציבות הסט לאורך זמן כדי שתוכלו למדוד מגמות במקום לרדוף אחרי תמונות-מצב חד-פעמיות.
הוסיפו פרומפטים רק כאשר המוצר שלכם משיק תכונה חדשה, מתחרה חדש נכנס לשוק, או שגיליתם דפוס שאלות של קונים שלא עקבתם אחריו. אם תשנו יותר מדי פרומפטים בבת אחת, תאבדו את היכולת להשוות תוצאות בין תקופות.
מסקנה מרכזית: ספריית פרומפטים הבנויה משפת קונים אמיתית היא הבסיס למעקב תחרותי שימושי. בלעדיה, אתם בודקים שאילתות אקראיות ומסיקים מסקנות לא אמינות.
שלב 2: תעדו את התגובה המלאה, לא רק אם אתם מופיעים
הטעות הנפוצה ביותר במעקב תחרותי של AI היא לטפל בו כבדיקה בינארית: האם המותג שלכם הופיע או לא. זה לא נותן לכם כמעט שום דבר לפעול לפיו. מה שחשוב הוא התמונה המלאה של התגובה — מי הופיע, באיזה סדר, עם איזו מסגרת, ועל בסיס אילו מקורות.
שמונת נקודות הנתונים לתיעוד עבור כל שילוב של פרומפט ומנוע
| נקודת נתון | מה לתעד | מדוע זה חשוב |
|---|---|---|
| מותג שהוזכר | כן או לא | אות נוכחות בסיסית |
| מומלץ | כן או לא | אזכור אינו זהה להמלצה |
| מיקום | היכן בתגובה מופיע המותג (ראשון, שני, ברשימה, בהערת שוליים) | אזכורים מוקדמים יותר נושאים אישור משתמע חזק יותר |
| מתחרים שצוינו | כל מותג אחר שהוזכר באותה תגובה | מראה מול מי אתם מושווים |
| מסגור ונרטיב | כיצד ה-AI מתאר כל מותג (לדוגמה, “הטוב ביותר לארגונים גדולים,” “המשתלם ביותר,” “אינטגרציות מוגבלות”) | חושף כיצד מערכות AI ממצבות אתכם ואת המתחרים שלכם |
| סנטימנט ודיוק | האם התיאור חיובי, ניטרלי, שלילי, או שגוי מבחינה עובדתית | תיאורים לא מדויקים יוצרים בעיה שניתן לתקן |
| מקורות וציטוטים | כל קישור, הפניה, או מקור שה-AI חושף | מספר לכם איזה תוכן מניע את ההמלצה |
| תאריך ומודל | מתי הרצתם את השאילתה ואיזו גרסת מודל AI השיבה | תשובות AI משתנות עם הזמן — דרוש לכם חותמת זמן למעקב אחר מגמות |
תעדו זאת עבור כל פרומפט בכל פלטפורמת AI שאתם עוקבים אחריה. גיליון אלקטרוני מתאים לכמה מחזורים ראשונים. אם היקף הנתונים גדל מעבר למה שאדם אחד יכול לנהל באופן עקבי, זהו אות לכך שדרוש לכם גישה שיטתית יותר.
כיצד ChatGPT ו-Perplexity שונים במה שניתן ללכוד
הבחנה זו חשובה מפני שפלטפורמות אלו אינן חושפות את אותו המידע, והתייחסות אליהן באופן זהה יוצרת נקודות עיוורון.
Perplexity מציגה את הציטוטים שלה במפורש. כל תשובה כוללת קישורי מקור ממוספרים שניתן ללחוץ עליהם כדי לראות בדיוק אילו דפי אינטרנט הובילו לתגובה. מבנה הציטוטים של Perplexity דומה למעין גרף קישורים נכנסים גלוי עבור תשובות שנוצרו על ידי AI. אם מתחרה מופיע בהשוואה ב-Perplexity, לעיתים קרובות ניתן לאתר את ההמלצה ישירות למאמר ביקורת ספציפי, שרשור פורום, או דף תיעוד.
ChatGPT פחות שקוף בנוגע למקורות. במצב רגיל, הוא לא תמיד מציג אילו מקורות הובילו לתגובה. בשימוש במצב החיפוש של ChatGPT, הוא יציג לעיתים קישורי מקור — אך הקשר בין מקור ספציפי לטענה ספציפית בתגובה קשה יותר לאיתור מאשר ב-Perplexity.
השלכה מעשית: נתוני Perplexity מעניקים לכם מודיעין מקורות אקציונלי יותר. נתוני ChatGPT מעניקים לכם אות רחב יותר על תפיסת המותג בתוך אימון המודל ואחזור המידע שלו. אתם זקוקים לשניהם, ועליכם לפרש אותם בצורה שונה.
מסקנה מרכזית: בדיקת נוכחות בלבד מבזבזת את זמנכם. לכידת הנתונים בשמונה נקודות היא מה שהופך תגובות AI גולמיות למודיעין תחרותי שניתן ממש לפעול לפיו.
שלב 3: חשבו את ששת ה-KPI התחרותיים שחשובים באמת
ברגע שיש לכם נתוני תגובה ממחזורי פרומפט מרובים, תוכלו לחשב מדדים שחורגים מתצפיות בודדות ומתחילים לחשוף דפוסים. להלן ששת המדדים שמשווקי מוצר צריכים לעקוב אחריהם — כל אחד עם נוסחה והסבר פשוט של מה הוא מגלה.
- שיעור אזכור = פרומפטים שבהם המותג שלכם מופיע ÷ סך הפרומפטים הרלוונטיים. מספר לכם באיזו תדירות מערכות AI מאזכרות את קיומכם בקטגוריה שלכם.
- שיעור המלצה = פרומפטים שבהם המותג שלכם מומלץ במפורש ÷ סך הפרומפטים הרלוונטיים. מספר לכם באיזו תדירות מערכות AI ממליצות עליכם באופן פעיל, ולא רק מציינות אתכם ברשימה.
- נתח קול ב-AI = סך האזכורים של המותג שלכם בכל הפרומפטים הנעקבים ÷ סך אזכורי המותגים של כל המתחרים באותה קבוצת פרומפטים. מציג את הנוכחות היחסית שלכם בתשובות המיוצרות על ידי AI לעומת השדה התחרותי.
- מיקום ממוצע = סכום דירוג המיקום שלכם בכל האזכורים ÷ מספר האזכורים. מספר לכם האם אתם נוטים להופיע ראשונים, שניים, או קבורים בתחתית הרשימות המיוצרות על ידי AI.
- עקירת מתחרים = פרומפטים שבהם מתחרה ספציפי מופיע והמותג שלכם אינו מופיע. מספר לכם בדיוק היכן אתם מפסידים קרקע ולמי.
- נתח ציטוטים = מספר דפי המקור הייחודיים המצטטים את המותג שלכם בתשובות AI ÷ סך דפי המקור הייחודיים שצוטטו בכל המותגים. מספר לכם עד כמה מערכת התוכן שלכם תומכת בהמלצות AI בהשוואה למתחרים.
ההיגיון האבחוני: מה שילובי מדדים באמת אומרים לכם
מדדים בודדים שימושיים. שילובי מדדים הם המקום שבו חיה התובנה האמיתית.
- שיעור אזכור גבוה, שיעור המלצה נמוך: מערכות AI יודעות שאתם קיימים אך אינן בוחרות בכם. בדרך כלל משמעות הדבר היא שה-AI שואב ממקורות המתארים את המוצר שלכם ללא המלצה עליו — או שלמתחרים יש אותות חזקים יותר על הממדים החשובים לרוכשים.
- עקירת מתחרים גבוהה בשאילתות השוואה: פער המסרים שלכם מתגלה בתשובות AI. הרוכש שואל שאלת השוואה ישירה, וה-AI עונה עם הנרטיב של המתחרה שלכם, לא שלכם.
- נתח ציטוטים נמוך למרות תוכן בבעלותכם חזק: האתר שלכם והבלוג שלכם אולי אינם התוכן שממנו מערכות AI שואבות מידע. מקורות צד שלישי — אתרי ביקורות, דוחות אנליסטים, פורומים, פרסומים טכניים — עשויים להניע המלצות יותר מכל דבר שאתם מפרסמים ישירות.
- שיעור האזכורים עולה אך הדירוג הממוצע יורד: אתם מופיעים ביותר תשובות, אך נמוך יותר ברשימה. זה יכול לקרות כאשר מתחרים חדשים נכנסים לתחום או כאשר מתחרים קיימים משפרים את כיסוי המקורות שלהם.
מסקנה מרכזית: נתח הקול של AI הוא המדד המרכזי, אך השילובים האבחנתיים מגלים לכם מה קורה בפועל והיכן להתמקד את מאמציכם.
שלב 4: בחרו גישת מעקב המתאימה למשאבים שלכם
אין דרך נכונה אחת לנהל תהליך זה. הגישה הנכונה תלויה בכמה פרומפטים אתם עוקבים אחריהם, בכמה פלטפורמות AI אתם מנטרים, ובכמה זמן הצוות שלכם יכול להקדיש באופן ריאלי.
מעקב ידני
מתאים ביותר לקביעת בסיס ראשוני ולצוותים עם פחות מ-50 פרומפטים. השתמשו בפרופיל דפדפן ייעודי (כדי להימנע מהשפעות התאמה אישית), הריצו את הפרומפטים לפי לוח זמנים עקבי, ותעדו תוצאות בגיליון אלקטרוני מובנה תוך שימוש במסגרת שמונת הנקודות משלב 2.
מעקב ידני עובד היטב לביסוס הבסיס הראשון שלכם. המגבלה היא שאינו מדרג, והוא מייגע דיו כדי שהעקביות תיפגע לאחר מספר שבועות, אלא אם כן מישהו אחראי עליו במפורש.
גישות API ואוטומציה
אם לצוות שלכם יש משאבים טכניים, תוכלו להשתמש ב-API של פלטפורמות AI כדי להריץ פרומפטים באופן תכנותי ולתעד תשובות אוטומטית. זה מפחית את העומס הידני ומשפר את העקביות, אך דורש זמן פיתוח להגדרה ותחזוקה — וגישה ל-API, תמחור ותנאים משתנים בין פלטפורמות.
פלטפורמות נראות AI ייעודיות
קטגוריה גוברת של כלים מתפתחת לטיפול במעקב נראות AI בקנה מידה. בעת הערכת פלטפורמות, חפשו את היכולת להריץ פרומפטים על פני מנועי AI מרובים, ללכוד נתוני תגובה מלאים (לא רק בדיקות אזכור בינאריות), לעקוב אחר מגמות לאורך זמן מול קבוצת פרומפטים יציבה, ולהשוות את הנראות שלכם מול מתחרים ספציפיים.
ביצוע שירות מלא
לצוותים שאינם רוצים לנהל דאשבורד נוסף, כלי נוסף, או תהליך עבודה פנימי נוסף, שותף שירות מלא יכול לטפל בתהליך כולו — ממחקר פרומפטים וניטור תחרותי ועד יצירת תוכן, פרסום ודיווח. זו הגישה ש-CiteHarbor מספקת: הביקורת, המעקב, התוכן, הפרסום ותמונת המצב החודשית של הביצועים, מסופקים כשירות מנוהל ולא כפלטפורמת תוכנה שעליכם להפעיל.
מסקנה מרכזית: התחילו ידנית כדי לבנות אינטואיציה ולקבוע בסיס השוואה. לאחר מכן החליטו האם להרחיב באמצעות אוטומציה, תוכנה או שירות מנוהל — בהתאם למה שהצוות שלכם יכול לקיים באופן ריאלי.
שלב 5: נתחו פערים של מתחרים ועקבו אחר המקורות שמאחוריהם
הנתונים הכי יקרי הערך במערכת המעקב שלכם אינם המקומות שבהם אתם מופיעים. אלו הם המקומות שבהם המתחרים שלכם מופיעים ואתם לא. פרומפטים של עקירת מתחרים אלו הם הפערים בעלי העדיפות הגבוהה ביותר שלכם — והבנת הסיבות לקיומם היא מה שהופך ניטור לאסטרטגיה.
זיהוי הפערים בעלי העדיפות הגבוהה ביותר שלכם
סננו את נתוני המעקב שלכם לפי פרומפטים שבהם לפחות מתחרה אחד מוזכר או מומלץ והמותג שלכם נעדר. לאחר מכן מיינו את הפרומפטים הללו לפי השפעה עסקית: שאילתות השוואה ושאילתות המלצה דחופות יותר משאילתות קטגוריה כלליות, מפני שהכוונה הרכישתית של הקונה ספציפית יותר וקרובה יותר להחלטה.
מעקב אחר המקורות שמאחורי המלצות המתחרים
כאשר מתחרה מופיע בהשוואה שנוצרה על ידי בינה מלאכותית, משהו מניע את ההמלצה הזו. ב-Perplexity, לעתים קרובות תוכלו לראות את המקורות המצוטטים ישירות. ב-ChatGPT, ייתכן שתצטרכו להריץ את אותה שאילתה במצב חיפוש ולבחון קישורי מקור שיופיעו, או לבחון את הנוכחות הרחבה באינטרנט של המתחרה לרמזים.
מקורות נפוצים שמניעים המלצות בינה מלאכותית כוללים:
- פרופילי אתרי ביקורות ודפי השוואה ב-G2, Capterra ו-TrustRadius
- פוסטים טכניים בבלוגים ותיעוד אינטגרציה
- דוחות אנליסטים בתעשייה ומדריכי שוק
- דיונים בפורומים ב-Reddit, Stack Overflow ואתרי קהילה ייעודיים
- סיקור תקשורתי ומאמרי הכרזות מוצר
- דפי השוואה שפרסמו המתחרים ותוכן מסוג “vs”
זוהי תובנה קריטית שצוותי שיווק מוצר רבים מפספסים: מערכות בינה מלאכותית שואבות לעתים קרובות יותר ממקורות צד שלישי מאשר מהתוכן שבבעלותכם. דף המוצר שלכם עשוי להיות מותאם היטב ל-Google, אך אם אתרי הביקורות, הפורומים ודוחות האנליסטים בקטגוריה שלכם אינם מזכירים אתכם לטובה, תשובות השוואת הבינה המלאכותית ישקפו פער זה.
ביקורת על המסגור ועל הדיוק של אזכורי המתחרים
מעבר לנוכחות, בחנו כיצד הבינה המלאכותית מתארת כל מתחרה. איזו נרטיב היא בונה? “הטוב ביותר לצרכי גדילה ארגונית.” “האפשרות הזולה ביותר.” “אינטגרציות חזקות אך עקומת למידה תלולה.” מסגורים אלו אינם אקראיים — הם השתקפויות של חומר המקור אליו גישה מערכת הבינה המלאכותית.
כאשר תיאור הבינה המלאכותית של המוצר שלכם אינו מדויק — ולעתים זה יקרה — עקבו אחר אי-הדיוק אל מקורו. האם הוא מבוסס על ביקורת מיושנת? שרשור פורום מלפני שלוש שנים? דף השוואה של מתחרה? הכרת מקור אי-הדיוק היא הצעד הראשון לתיקונו.
מסקנה עיקרית: פערי מתחרים אינם רק בעיות נראות. הם בעיות של מערכת אקולוגית של תוכן. סגירתם מחייבת הבנה של אילו מקורות מניעים המלצות AI ואם למותג שלכם יש כיסוי מספיק באותם מקורות.
שלב 6: הפכו נתוני אזכורי מתחרים לפעולות תוכן ומיצוב
מעקב ללא פעולה הוא רק ניהול רשומות. הערך של מערכת זו טמון במה שאתם עושים עם הנתונים. להלן התרחישים הנפוצים ביותר והתגובות המתאימות להם.
כאשר מתחרה מנצח בניסוח ספציפי
אם מתחרה מתואר באופן עקבי כ”הטוב ביותר ל[מקרה שימוש ספציפי]” והמוצר שלכם משרת גם הוא מקרה שימוש זה, עקבו אחר הניסוח עד למקורותיו. לעתים קרובות תגלו שלמתחרה יש מדריך פורסם, דף נחיתה ייעודי, או כיסוי של גורם שלישי המתייחס באופן ספציפי לאותו מקרה שימוש — ואילו לכם אין.
התגובה: צרו תוכן שמתייחס ישירות לאותו מקרה שימוש עם פירוט ברור, ספציפי ומגובה בניסיון. פרסמו אותו באתר שלכם. השיגו כיסוי במקורות של גורמים שלישיים שה-AI כבר מצטט מהם. עדכנו את תיעוד המוצר שלכם כדי לשקף את היכולת.
כאשר מתחרה מופיע בשאילתות השוואה ואתם לא
זהו הפער הנפוץ ביותר. הקונה משווה במפורש בין פתרונות, והמותג שלכם נעדר מתשובת ה-AI.
התגובה: פרסמו תוכן השוואה מובנה היטב באתר שלכם. ודאו שהמוצר שלכם מופיע ומתואר במדויק באתרי הביקורות והמדריכים שה-AI מצטט מהם. חפשו פערי תוכן בפורומים ובאתרי קהילה שבהם קונים דנים בקטגוריה שלכם. צרו מאמרים ממוקדים המשיבים על שאלות הקונה המדויקות שספריית הפרומפטים שלכם זיהתה.
זהו סוג העבודה שCiteHarbor עושה עבור לקוחות — זיהוי שאלות הקונה הספציפיות שבהן קיימים פערי נראות, יצירת תוכן שנועד לטפל בפערים אלה, פרסומו באתר WordPress של הלקוח, הפצתו דרך ערוצים חברתיים, ומעקב אחר שיפור הנראות לאורך זמן.
כאשר תיאור ה-AI של המוצר שלכם אינו מדויק
תשובות AI הן הסתברותיות. הן נוצרות מתבניות בנתונים שעליהם אומן המודל או שנשלפו מהאינטרנט. לעתים התיאור שהן מייצרות על המוצר שלכם מיושן, מטעה או שגוי.
התגובה עוקבת אחר תהליך עבודה ספציפי:
- זהו את הטענה הלא מדויקת בתשובת ה-AI.
- עקבו אחריה עד למקור הסביר — אתר ביקורות, פוסט בפורום, מאמר מיושן, או תוכן שפרסם מתחרה.
- אם המקור נמצא בפלטפורמה שביכולתכם להשפיע עליה (האתר שלכם, פרופיל ביקורות, דף שותף), עדכנו אותו עם מידע מדויק.
- אם המקור הוא דף של גורם שלישי שאינכם יכולים לערוך ישירות, צרו תוכן בבעלותכם שמתייחס באופן ברור וספציפי לאי-הדיוק עם מידע עדכני וניתן לאימות.
- עקבו אחרי אותה הנחיה במחזורי מעקב עתידיים כדי לראות אם תגובת הבינה המלאכותית מתעדכנת.
מסקנה מרכזית: כל פער בנתוני המעקב שלכם מול מתחרים הוא בעיה ספציפית וניתנת לטיפול של תוכן או מיצוב. מערכת המעקב מראה לכם היכן להתמקד. תגובת התוכן היא מה שיש לה סיכוי לשנות את התוצאה לאורך זמן.
שלב 7: בנו קצב תפעולי חוזר
ביקורות חד-פעמיות שימושיות לביסוס בסיס השוואה. אך תשובות שנוצרות על ידי בינה מלאכותית משתנות ככל שהמודלים מתעדכנים, כשתוכן חדש מתפרסם וכשהתנהגות המשתמשים מתפתחת. מודיעין תחרותי ממעקב בינה מלאכותית אמין רק אם הוא נאסף באופן עקבי לאורך זמן.
קצב מומלץ
- שבועי: הריצו את מערך ההנחיות המרכזי שלכם על פני ChatGPT ו-Perplexity. סמנו כל שינוי מרכזי באזכורי מתחרים, מתחרים חדשים שמופיעים, או שינויים במסגור.
- חודשי: חשבו את ששת ה-KPI שלכם. נתחו את הנרטיבים התחרותיים ואת שינויי המקורות. זהו את הפערים בעלי הסדר העדיפויות הגבוה ביותר לתגובת תוכן. השוו את התוצאות לחודש הקודם.
- רבעוני: רעננו את מערך ההנחיות שלכם — הוסיפו שאלות קונים חדשות, הוסיפו מתחרים חדשים אם רלוונטי, הסירו הנחיות שאינן חשובות אסטרטגית עוד. סקרו את מגמות נתח הציטוט שלכם ואת נוף מקורות הצד השלישי.
- לאחר השקה: לאחר השקת מוצר, פרסום תכונה, או דחיפת תוכן מרכזית, הריצו מדידת לפני-ואחרי מול מערך בקרה קבוע של הנחיות כדי לראות אם הנראות שלכם השתנתה.
קצב זה הוא החלק שמתמוטט לרוב אצל צוותים פנימיים. הרצת הנחיות, הקלטת נתונים, חישוב מדדים, ניתוח פערים וחיבור הממצאים לאסטרטגיית תוכן הם מחויבות תפעולית משמעותית. זו אינה פרויקט רבעוני — זו פונקציית מודיעין מתמשכת.
זו אחת הסיבות העיקריות שצוותים בוחרים לעבוד עם שירות מנוהל כמו CiteHarbor. במקום להוסיף עוד משימה חוזרת לעומס העבודה של משווק מוצר, כל התהליך — ביקורת, מחקר הנחיות, מעקב תחרותי, יצירת תוכן, פרסום, הפצה ודיווח — מטופל חיצונית. הלקוח מקבל תמונת מצב חודשית ממותגת של ביצועים במקום לנהל עוד לוח מחוונים.
הערה על אמינות תשובות בינה מלאכותית בניתוח תחרותי
מערכת זו מספקת לכם אותות תחרותיים שימושיים. היא אינה מספקת לכם אמת שטח לגבי תפיסת השוק.
תשובות השוואה שנוצרות על ידי בינה מלאכותית הן הסתברותיות. אותה הנחיה יכולה לייצר תוצאות שונות בזמנים שונים, בימים שונים ובגרסאות מודל שונות. שאילתות השוואה בפרט נצפו כמייצרות תוצאות לא עקביות ולעיתים סותרות על פני פלטפורמות בינה מלאכותית שונות.
המשמעות בפועל:
- אל תתייחסו לתגובה בודדת של AI כראיה למגמת שוק. חפשו דפוסים על פני מספר שאילתות ומחזורי מעקב מרובים.
- תמיד עקבו אחר טענות של AI למקורותיהן לפני שתפעלו על פיהן. מערכת AI עשויה לתאר מתחרה בצורה חיובית בהתבסס על מאמר ישן או ביקורת בודדת — זהו נתון, לא מסקנה.
- השתמשו בנתוני מעקב AI כאות לחקירה, לא כתחליף למחקר לקוחות ישיר, ניתוח ניצחון/הפסד, או מודיעין תחרותי מסורתי.
- היו זהירים במיוחד לגבי טענות דיוק — תיאורי AI של תכונות, תמחור ויכולות המתחרים שלכם עשויים להיות שגויים. אמתו לפני שתגיבו באופן אסטרטגי.
תהליך האימות המומלץ: תשובת AI → מקורות מצוטטים → אימות מקורות → פעולה שיווקית. לעולם אל תדלגו על שלב האימות.
המסקנה המרכזית: מעקב תחרותי באמצעות AI הוא שכבת מודיעין יקרת ערך, לא לוח תוצאות מוחלט. השתמשו בו לצד תוכנית המודיעין התחרותי הקיימת שלכם, לא כתחליף לה.
מה משמעות נתח הנוכחות של AI לצוותי שיווק מוצר המשקיעים כבר ב-SEO
אם הצוות שלכם כבר משקיע בדירוגי מילות מפתח, אופטימיזציה של אתרי ביקורות ושיווק תוכן, אתם לא מתחילים מאפס. רוב תשתית התוכן התומכת בנראות בחיפוש מסורתי תומכת גם בנראות ב-AI — אך הפערים בין השניים הם ממשיים וגדלים.
הדפוס הנפוץ ביותר שאנו מבחינים בו: חברת SaaS מדורגת היטב עבור מילות מפתח קטגוריאליות ב-Google, יש לה פרופילים חזקים באתרי ביקורות ומפרסמת תוכן בלוג באופן סדיר — אך כאשר קונה שואל את ChatGPT או Perplexity להשוות כלים באותה קטגוריה, החברה אינה מופיעה, או מופיעה עם מסגור לא מדויק.
זה קורה מכיוון שמערכות AI שואבות ממגוון שונה של מקורות, מעניקות משקל שונה לתוכן, ובונות נרטיבים משלהן במקום פשוט לדרג דפים. מיקומי מילות המפתח שלכם אינם מתורגמים אוטומטית להמלצות AI. פוסטי הבלוג שלכם, אם הם נכתבו כדי לדרג עבור שאילתות חיפוש ולא כדי לענות על שאלות קונים עם מידע ברור, מובנה וניתן לציטוט, עשויים שלא להיות סוג התוכן שמערכות AI שואבות ממנו.
מערכת המעקב התחרותי המתוארת במדריך זה מספקת לכם את הנתונים לראות בדיוק היכן קיימים פערים אלה — ומסגרת לסגירתם באמצעות תוכן ממוקד שאלות-קונים, במקום נפח בלוג גנרי יותר.
שאלות נפוצות
מהו נתח הנוכחות של AI וכיצד מחשבים אותו?
מדד נתח הקול של AI מודד את נראות המותג שלכם בתשובות שנוצרות על ידי AI ביחס למתחרים שלכם. לחישובו, קחו את סך ספירות האזכורים של המותג שלכם בכל הפרומפטים הנעקבים וחלקו אותו בספירת האזכורים המצטברת של כל המותגים — שלכם וכל המתחרים — באותו מערך פרומפטים. ציון גבוה יותר פירושו שמערכות AI מציגות את המותג שלכם באופן עקבי יותר מאשר את האלטרנטיבות המתחרות בעת מענה על שאלות קונים בקטגוריה שלכם.
באיזו תדירות כדאי להריץ את הפרומפטים האלה?
מדי שבוע עבור מעקב פרומפטים מרכזי, מדי חודש עבור ניתוח KPI מלא, ומדי רבעון לבחינת מערך הפרומפטים ורענונו. לאחר השקות מוצר או דחיפות תוכן גדולות, הריצו השוואת לפני-ואחרי ממוקדת. העקביות חשובה יותר מהתדירות — קצב שבועי יציב מניב נתוני מגמה טובים יותר מצלילות עומק ספוראדיות.
האם אתם זקוקים לכלי בתשלום, או שאפשר לעשות זאת ידנית?
אתם יכולים להתחיל ידנית עם גיליון אלקטרוני ופרופיל דפדפן ייעודי. מעקב ידני עובד היטב לביסוס בסיס עם 30 עד 50 פרומפטים. אם תתרחבו מעבר לכך, או אם העקביות הופכת לבעיה, שקלו אוטומציה באמצעות API, פלטפורמת נראות AI ייעודית, או שירות מנוהל שמטפל במעקב עבורכם.
מה כדאי לעשות כאשר מתחרה מופיע בתשובות AI ואתם לא?
עקבו אחר האזכור של המתחרה עד למקורות הסבירים שלו — אתרי ביקורות, תיעוד, תוכן מפורסם, דיוני פורומים. זהו את פערי התוכן או הכיסוי הספציפיים המסבירים את נוכחותם והיעדרכם. לאחר מכן צרו תוכן ממוקד המתייחס לאותה שאלת קונה, פרסמו אותו באתר שלכם, ושאפו לכיסוי במקורות צד שלישי שמערכת ה-AI ציטטה. עקבו אחר אותם פרומפטים במחזורים עתידיים כדי לעקוב אחר שינויים.
במה שונה מעקב אחר אזכורי מתחרים ב-Perplexity ממעקב ב-ChatGPT?
Perplexity חושף את ציטוטי המקורות שלו ישירות בכל תשובה, מה שמאפשר לכם לראות בדיוק אילו דפי אינטרנט הנחו את ההמלצה. ChatGPT פחות שקוף לגבי המקורות שלו במצב הרגיל, אם כי מצב החיפוש שלו מציג לעיתים קישורים. בפועל, Perplexity מעניק לכם מידיעת מקורות פעילה יותר, בעוד ש-ChatGPT מעניק לכם אות רחב יותר לגבי האופן שבו המותג שלכם נתפס ברחבי נתוני האימון והאחזור של המודל.
האם זה מחליף מודיעין תחרותי מסורתי?
לא. מעקב תחרותי ב-AI הוא שכבת מידיעה נוספת, לא תחליף. הוא מספר לכם כיצד מערכות AI ממסגרות את הקטגוריה שלכם וממליצות על המתחרים שלכם — מידע שניתוח תחרותי מסורתי אינו לוכד. השתמשו בו לצד ניתוח ניצחון/הפסד, מחקר לקוחות, ניטור ביקורות וניתוח שוק לתמונה תחרותית מלאה.
מעבר ממעקב לפעולה
המערכת המתוארת כאן מעניקה למשווקי מוצרים תהליך ברור וניתן לחזרה להבנת האופן שבו פלטפורמות AI מתארות, ממליצות ומשוות מתחרים בקטגוריה שלכם. הערך אינו בעצם המעקב — אלא בהחלטות התוכן, המיצוב וכיסוי המקורות שהמעקב מאפשר.
לצוותים שרוצים להפעיל את התהליך הזה באופן פנימי, המסגרת במדריך זה תוכננה להיות ישימה באופן מיידי. התחילו עם ספריית פרומפטים של רוכשים, הריצו את הבייסליין הראשון שלכם, לכדו את נתוני התגובה המלאים וחשבו את ה-KPI הראשוניים שלכם. תדעו תוך שניים-שלושה מחזורים היכן הפערים שלכם ומה עליכם לעשות בנוגע אליהם.
לצוותים שמעדיפים שלא לנהל עוד תהליך עבודה — מחקר הפרומפטים, מעקב התחרותי, יצירת התוכן, הפרסום, ההפצה, המעקב והדיווח החודשי — CiteHarbor מטפלת בתהליך המלא כשירות מנוהל. ללא דשבורד להתחבר אליו. ללא כלי חדש ללמוד. ללא נטל ניהולי פנימי נוסף.