האם אתם זקוקים לאסטרטגיית תוכן נפרדת לנראות ב-Perplexity?
אינכם זקוקים לאסטרטגיית תוכן נפרדת עבור Perplexity, אך עליכם להתאים את האופן שבו אתם מבנים, מרעננים ומייחסים תוכן לצורך ציטוט בחיפוש מבוסס בינה מלאכותית. מאמר זה מסביר מה עובר מ-SEO, מה צריך להשתנות, וכיצד למדוד נראות לאורך זמן.
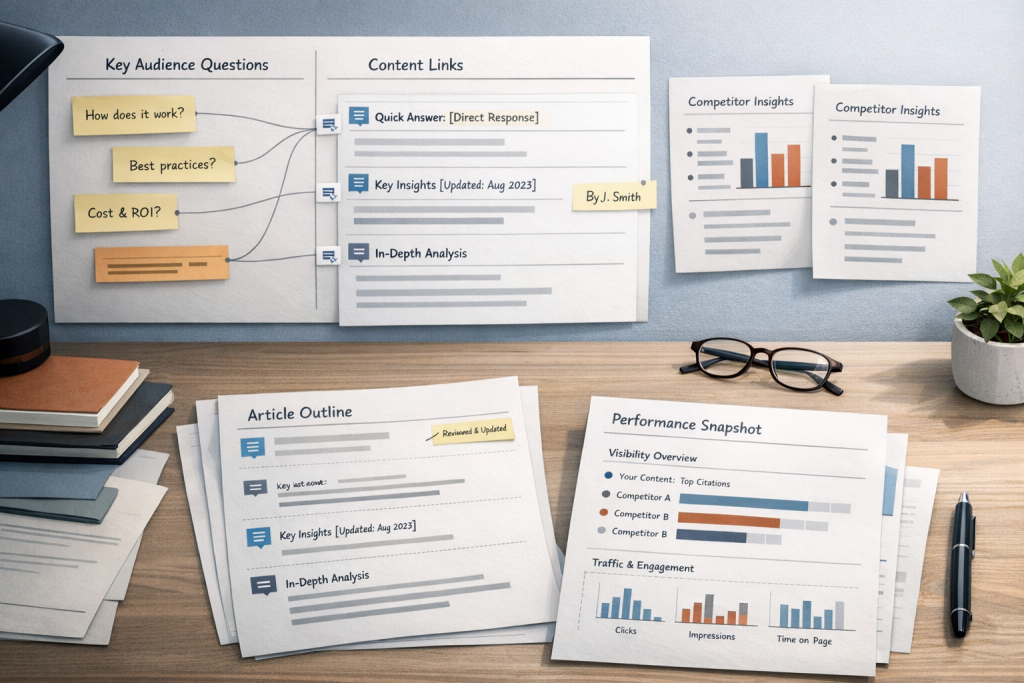
האם אתם זקוקים לאסטרטגיית תוכן נפרדת עבור נראות Perplexity?
התשובה הקצרה היא לא — בנייה מחדש מלאה אינה מה ש-Perplexity דורש. מה שהוא כן דורש הוא הבנה ברורה של היכן Perplexity סוטה מ-Google, מכיוון שלסטיות אלו יש השלכות ממשיות על האופן שבו אתם מבנים תוכן, עד כמה תכופות אתם מרעננים אותו, ועד כמה ברור אתם מאותתים על המומחיות שמאחוריו. רוב תוכנית ה-SEO המנוהלת היטב עוברת ללא שינוי. הפער בין תוכן חיפוש מסורתי לתוכן מוכן ל-Perplexity הוא אמיתי אך צר יותר ממה שהרכילות בתעשייה מרמזת — ובדיוק בגלל פער זה, מותגים עם דירוגי Google חזקים לפעמים אינם מצוטטים כלל בתשובות Perplexity.
מאמר זה עובר על מה שעובר מהתוכנית הקיימת שלכם, מה מצריך התאמה מכוונת, וכיצד למדוד אם ההתאמות הללו מניבות תוצאות. אם אתם CMO, מנהל SEO, אחראי תוכן, או משווק מוצר עם השקעה פעילה בחיפוש, זהו הפירוט התפעולי שכדאי לקרוא לפני שמתחייבים לכיוון חדש.
כיצד Perplexity שולף תוכן באופן שונה מ-Google
השאלה חשובה רק משום ש-Perplexity פועל על מודל שליפה שונה מהותית מ-Google. הבנת המכניקה נכון היא הדרך המהירה ביותר להבין מה צריך להשתנות בפועל.
שליפה חיה במקום דירוגים מובנים מראש
המודל של Google מובן היטב: הוא סורק את האינטרנט ברציפות, בונה אינדקס קבוע, ומדרג דפים מול שאילתות נכנסות באמצעות אותות הכוללים סמכות קישורים, רלוונטיות ומאות גורמים נוספים. חיפוש של משתמש מחזיר רשימה מדורגת השאובה מאותו אינדקס קיים מראש.
Perplexity פועל באופן שונה ברמה המבנית. בכל פעם שמשתמש מגיש שאלה, Perplexity מבצע שאילתה על האינטרנט החי, שולף תוכן ממקורות מרובים באותו רגע, מסנתז תגובה, ומציף את המקורות שמהם שאב. אין רשימה מדורגת מראש שממתינה להיות מוגשת. התוכן שלכם מוערך בזמן השאילתה — לא במהלך סריקה שהתרחשה בשבוע שעבר.
ההשלכה המעשית: עדכניות, בהירות ונגישות מבנית נושאות משקל מיידי רב יותר מאשר בדרך כלל בחיפוש המסורתי.
כיצד PerplexityBot מעבד את הדפים שלכם
Perplexity מפעיל סורק אינטרנט משלו, PerplexityBot, כדי לשלוף תוכן מרחבי האינטרנט. בעוד ש-Google מעריך דף בצורה הוליסטית כמסמך בר-דירוג, PerplexityBot ניגש לדפים באופן שונה — הוא מפצל תוכן לסעיפים נפרדים ומעריך האם קטעים בודדים מכילים תשובות ישירות וניתנות לחילוץ לשאלה שבידיו.
ההשלכה שרוב תוכניות התוכן מתעלמות ממנה: דף יכול להיות כתוב היטב ובכל זאת לייצר אפס ציטוטים מ-Perplexity, אם הסעיפים שלו אינם עצמאיים מספיק כדי שניתן יהיה לשלוף ולייחס אותם בפני עצמם. כל סעיף מרכזי צריך לעמוד בפני עצמו כיחידת תשובה עצמאית — ולא רק כאלמנט תומך בתוך טיעון ארוך יותר.
תאריכי פרסום כאות אמינות גלויה
כאשר Perplexity מצטטת מקור, היא מציגה לעיתים קרובות את תאריך הפרסום או העדכון של אותו מקור לצד הציטוט — גלוי למשתמש הקצה, ולא מוסתר במטא-נתונים. נראה שהדבר משפיע על בחירת המקורות כאשר מספר דפים עונים על אותה שאלה. דף שעבר עדכון עדכני ומהותי נוטה לשאת משקל רב יותר מדף ישן שלא עודכן, גם כאשר לדף הישן יש סמכות קישורים חיצוניים חזקה יותר.
עבור צוותי תוכן, זה ממסגר מחדש את הרעננות ממשימת היגיינת דירוג לאות אמינות גלויה שהמשתמשים יכולים לראות ולשקול בעצמם.
מה מועבר ישירות מתוכנית ה-SEO הקיימת שלכם
תוכנית SEO או תוכן פעילה כבר מייצרת ערך משמעותי הרלוונטי ל-Perplexity. הנה מה שחל ללא שינוי.
סמכות מבוססת ואותות קישורים
Perplexity שואבת מהאינטרנט הפתוח, ודפים בעלי סמכות אמיתית — שנבנתה באמצעות ציטוטים חיצוניים, פרסום עקבי, והכרה ממקורות אמינים — נוטים להופיע באופן אמין יותר מדפים דקים או חדשים ללא רקורד חיצוני. הסמכות שתוכניתכם כבר בנתה היא נכס פעיל.
עומק נושאי וכיסוי תוכן
אם תוכנית התוכן שלכם בנתה אשכולות סביב תחומי נושא מרכזיים — גישה לנושא מזוויות מרובות, עם פיסות מקושרות הדדית המחזקות זו את זו — עומק זה ממשיך לפעול לטובתכם. אחזור המידע של Perplexity נוטה להעדיף מקורות המפגינים מעורבות מתמשכת ומהותית בנושא על פני אתרים שמתייחסים אליו פעם אחת בפוסט שטחי.
נגישות טכנית
אתר שתקין מבחינה טכנית עבור Google — HTML נקי, ביצועי טעינה סבירים, קישור פנימי תפקודי, תצורת קנוניקל מדויקת — נגיש בדרך כלל גם ל-PerplexityBot. תחום אחד הראוי לאימות: תוכן המסתמך מאוד על עיבוד JavaScript בצד הלקוח או הנמצא בתוך קובצי PDF עשוי שלא להיות נגיש באופן אמין ל-PerplexityBot כפי שהוא נגיש ל-Googlebot. תוכן מרכזי צריך להיות זמין ב-HTML רגיל וניתן לסריקה.
כדאי גם לאשר שקובץ robots.txt שלכם אינו מגביל את PerplexityBot. סורק חסום פירושו אפס ציטוטים, ללא קשר לאיכות התוכן.
עיצוב שכבר עבר אופטימיזציה לתשובות ישירות
תוכן המובנה עבור קטעי המידע המומלצים של Google — עם היררכיות כותרות ברורות, פסקאות תמציתיות, רשימות עם תבליטים ותשובות הממוקמות בראש הקטעים — מתורגם ישירות למודל החילוץ של Perplexity. אם הצוות שלכם כבר השקיע בסוג זה של משמעת עיצוב, אינכם מתחילים מאפס.
מה ספציפית צריך להשתנות
כאן מתקיימת העבודה המהותית. אלו אינן התאמות קוסמטיות — אך גם אינן החלפת אסטרטגיה מקיפה. דילוג עליהן הוא ההסבר הנפוץ ביותר לכך שמותגים עם תוכניות SEO חזקות עדיין אינם מופיעים בתשובות Perplexity.
פתיחה עם התשובה: מבנה לחילוץ, לא לבניית נרטיב
תוכן SEO ארוך-טווח מסורתי בונה לעיתים קרובות לקראת מסקנה — הקשר תחילה, תשובה לאחר מכן. מודל החלוקה לנתחים של Perplexity הופך עדיפות זו. המשפטים הפותחים של כל קטע נושאים משקל גדול מהפרופורציה, מכיוון שאלו הם מה ש-PerplexityBot סביר ביותר לחלץ כבלוק תשובה עצמאי. תשובה הקבורה בפסקה הרביעית של קטע בן שבע פסקאות עשויה שלא להיאסף כלל.
ההתאמה הנדרשת: פיתחו כל קטע מרכזי עם התשובה הישירה או הטענה המרכזית, ולאחר מכן פתחו את ההקשר התומך מתחתיה. זה אינו עניין של פישוט התוכן שלכם — אלא של מיקום התוכן במקום שבו מערכת האחזור יכולה למצוא אותו.
התייחסות לרעננות כהתחייבות עריכה שוטפת
רוב תוכניות SEO מתייחסות לעדכוני תוכן באופן תגובתי — חוזרות לדפים כאשר הדירוגים יורדים או התנועה פוחתת. עבור נראות ב-Perplexity, רעננות צריכה להיות משמעת יזומה ומתוזמנת, ולא תגובת תחזוקה.
הכוונה אינה לגעת בתאריכי הפרסום מבלי לשנות את התוכן הבסיסי. הכוונה היא לבנות מחזורי סקירה קבועים ביומן העריכה שלכם — לוודא שהמידע עדכני, שהדוגמאות עדיין רלוונטיות, ושתאריך העדכון הגלוי משקף עבודת עריכה אמיתית. מכיוון ש-Perplexity מציגה תאריכים אלו למשתמשים, חותמת זמן מיושנת לצד דף שנבדק לאחרונה של מתחרה יוצרת חיסרון אמינות מיידי.
בהירות ישות: קביעת מי מדבר ומדוע זה חשוב
מסגרת E-E-A-T של Google — ניסיון, מומחיות, סמכותיות, אמינות — עיצבה זה מכבר את האופן שבו איכות נמדדת בחיפוש. Perplexity נראית מייחסת משקל לאותות אנלוגיים, עם תשומת לב מיוחדת לבהירות ישות: האם המערכת יכולה לזהות מי יצר את התוכן ומדוע מקור זה נושא סמכות רלוונטית בנושא.
בפועל, משמעות הדבר היא:
- ייחוס בשם המחבר על מאמרים, מקושר לדפי מחבר המבססים כישורים רלוונטיים
- סכמת ארגון המזהה בבירור את העסק שלכם בנתונים מובנים
- סכמת אדם עבור תורמים בודדים במקום המתאים
- שימוש עקבי בשם הארגון שלכם ובמומחים הנקובים בשמם לאורך התוכן שלכם
תוכן שיכול היה להיות מפורסם על ידי כל מקור אנונימי נותן ל-Perplexity פחות סיבה לבחור בו על פני מתחרה עם ייחוס ברור יותר.
מיקוד בשאלות שהקונים שואלים בפועל
מחקר מילות מפתח קונבנציונלי בנוי סביב ביטויי חיפוש ונתוני נפח. משתמשי Perplexity נוטים להגיש שאלות בצורה מלאה, שיחותית, ולעיתים קרובות בעלת חלקים מרובים — סוג השאילתות הספציפיות, בשלב קבלת ההחלטות, שכלי מילות המפתח מזלזלים בהן או מחמיצים אותן לחלוטין.
תכנון תוכן אפקטיבי עבור Perplexity דורש זיהוי השאלות האמיתיות שהקונים שלכם שואלים בשלבים שונים של הערכה — כולל שאלות השוואה, שאלות המשך, ושאלות שעולות ממש לפני החלטת הרכישה. מחקר שאלות-קונים זה שונה ממחקר מילות מפתח הן בשיטה והן בהיקף, והוא מפיק מפת דרכים תוכן שונה במשמעותה.
יצירת תוכן הראוי לציטוט
מכיוון ש-Perplexity מצטט את מקורותיו, הוא בוחר באופן פעיל לאיזה מקור לייחס כל טענה. דפים המציעים מידע ספציפי, שניתן לאמת אותו, ומיוחס בבירור, נבחרים בסבירות גבוהה יותר מדפים שחוזרים על ידע נפוץ מבלי לתרום שום דבר ייחודי.
מבחן שימושי: לכל טענה שהתוכן שלכם מעלה, שאלו את עצמכם האם היא מוחשית וספציפית מספיק כדי לצטט אותה ישירות. טענות מעורפלות על מגמות בתעשייה אינן ניתנות לציטוט. תיאורים מדויקים של אופן פעולת מערכת, מה דורש תהליך, או מה כרוכה בו החלטה — הם כן. ספציפיות וייחוס ברור הם מה שמפריד בין מקור הניתן לציטוט לבין תוכן ממלא שעובר סינתזה והופך לאלמוני.
השינוי הבסיסי באופן שבו אתם חושבים על נראות
ההתאמות הטקטיות שלעיל הן בעלות משמעות, אך הן נובעות משינוי בסיסי יותר בכיוון.
SEO מסורתי שואל: כיצד נדרג דף זה עבור מילת מפתח זו?
נראות בסגנון Perplexity שואלת: האם המותג שלכם הוא סוג המקור שמערכת זו תגלה, תאמין בו ותצטט אותו כאשר מגיעה שאלה רלוונטית?
זה אינו הבדל סמנטי. זה משנה את מה שאתם בונים ואת מה שאתם מודדים. מודל הדירוג מייעל דפים בודדים עבור שאילתות בודדות. מודל הציטוט בונה מאגר תוכן שמבסס את הארגון שלכם כסמכות אמינה וניתנת לציטוט ברחבי השאלות שהקונים שלכם שואלים.
שינוי כיוון זה אינו מחליף את SEO. הוא פועל לצדו. אך הוא אכן משנה את סדרי העדיפויות בתכנון התוכן — אילו נושאים אתם מכסים, כיצד אתם מבנים את מה שאתם מפרסמים, ומה נחשב לתוצאה משמעותית.
כיצד לדעת אם זה עובד: מדידת נראות ב-Perplexity
רוב ההנחיות בנושא אופטימיזציה של Perplexity נעצרות לפני שמתייחסות למדידה. התאמת התוכן שלכם שימושית רק אם אתם יכולים לקבוע האם ההתאמות הללו מניבות תוצאות.
מה לנטר
- תדירות ציטוט המותג בתשובות שנוצרו על ידי בינה מלאכותית: באיזו תדירות מופיע הארגון שלכם כאשר Perplexity מגיב לשאלות בקטגוריה שלכם? זהו בסיס הנראות המרכזי שלכם.
- דפוסי ציטוט של מתחרים: אילו מתחרים מצוטטים עבור אותן שאלות קונים שבהן המותג שלכם נעדר? היכן בדיוק הם מופיעים ואתם לא?
- תנועת הפניות מפלטפורמות בינה מלאכותית: כאשר Perplexity מקשר לתוכן שלכם כמקור מצוטט, אותה תנועה מדידה בנתוני האנליטיקס שלכם. עקבו אחריה כערוץ נפרד.
- כיסוי שאלות הקונים: מתוך השאלות הרלוונטיות ביותר להחלטות הקונים שלכם, על כמה מהן עונה התוכן שלכם בצורה ישירה וברורה מספיק כדי שניתן יהיה לחלץ אותו?
ביקורת התוכן הקיים שלכם למוכנות ל-Perplexity
ביקורת התחלתית מעשית בוחנת את הדפים בעלי הערך הגבוה ביותר שלכם מול הקריטריונים הבאים:
- האם כל סעיף מרכזי פותח בתשובה ישירה במקום לבנות לעברה?
- האם הסעיפים הבודדים קוהרנטיים מספיק כדי לחלץ אותם ולצטט אותם ללא הקשר מקיף?
- האם תאריך פרסום או עדכון מהותי גלוי בדף ועדכני באופן סביר?
- האם קיים ייחוס ברור למחבר או לארגון?
- האם הדף משתמש בנתונים מובנים מדויקים — סכמת Article, Organization, או Person בהתאם?
- האם התוכן העיקרי מעובד ב-HTML הניתן לסריקה במקום ב-JavaScript או קובצי PDF מוטמעים?
- האם robots.txt מאפשר גישת סריקה ל-PerplexityBot?
דף שנכשל ביותר משניים מבדיקות אלה אינו צפוי לזכות בציטוטים של Perplexity, ללא קשר למיקומו בדירוג Google.
קביעת תדירות ניטור
התנהגות הציטוטים של Perplexity אינה קבועה. ככל שתוכן חדש נכנס לרשת והמערכת ממשיכה להתפתח, המקורות שמצוטטים — ועבור אילו שאלות — משתנים עם הזמן. ניטור חודשי הוא המינימום המעשי: מעקב אחר נוכחות הציטוטים של המותג שלכם מול סט עקבי של שאלות קונים, השוואה מול מתחרים, וזיהוי פערים מתעוררים לפני שהם מצטברים.
זו אינה ביקורת חד-פעמית. זהו לולאת משוב חוזרת המכוונת הן את הפקת התוכן והן את סדרי העדיפויות לעדכון.
מדוע המציאות התפעולית קשה יותר מהמושג
ההתאמות המתוארות לעיל אינן מסובכות מבחינה מושגית. האתגר הוא ביישום בקנה מידה, לאורך זמן.
מחקר שאלות הקונים אינו משימה חד-פעמית — הוא דורש עדכון מתמיד ככל ששאלות השוק שלכם מתפתחות על פני מספר פלטפורמות AI. ארגון מחדש של תוכן משמעותו חזרה לדפים קיימים, לא רק הפקת דפים חדשים. ניהול רעננות דורש משמעת לוח עריכה על גבי מחויבויות הפקה קיימות. עבודת אותות ישויות כוללת נתונים מובנים ודפי מחברים שרוב צוותי התוכן אינם מתחזקים באופן פעיל. מעקב אחר ציטוטים דורש ניטור פלטפורמות AI מדי חודש עם עקביות מספקת כדי לחשוף מגמות משמעותיות.
עבור צוותים המנהלים כבר SEO, מדיה בתשלום, רשתות חברתיות והפקת תוכן, קליטת זה כזרם עבודה פנימי נוסף בדרך כלל משמעותה שהוא מקבל עדיפות נמוכה יותר או מבוצע באי-עקביות.
זוהי הבעיה התפעולית שלשמה נבנה CiteHarbor. CiteHarbor מנהל את זרם העבודה המלא — ממבדק נראות AI ומחקר שאלות קונים ועד יצירת מאמרים, פרסום ב-WordPress, הפצה ברשתות חברתיות, ניטור ציטוטי מתחרים ודיווח ביצועים חודשי ממותג — כך שהצוות שלכם אינו צריך לנהל עוד לוח מחוונים, עוד לוח תוכן, או עוד רשימה של פרילנסרים. הפלט הוא תמונת מצב חודשית ברורה של מיצוב המותג שלכם, המועברת כ-PDF ממותג במקום כניסה לפלטפורמה נוספת.
רצף פתיחה מעשי
אם אתם מעריכים כיצד להתאים את גישת התוכן שלכם עבור Perplexity, להלן סדר פעולות ריאליסטי:
- קבעו את קו הבסיס הנוכחי של הנראות שלכם. הגישו את השאלות שהקונים שלכם שואלים ישירות ל-Perplexity. תעדו היכן המותג שלכם מופיע, היכן מתחרים מופיעים, והיכן אף אחד בקטגוריה שלכם אינו מופיע כלל.
- זהו את שאלות הקונים בעלות הערך הגבוה ביותר שלכם. תעדיפו שאלות הקשורות להחלטות רכישה פעילות על פני שאילתות מידע בעלות נפח חיפוש גבוה אך כוונה מסחרית נמוכה.
- הערכו תוכן קיים מול קריטריוני מוכנות ל-Perplexity. השתמשו ברשימת הבדיקה לעיל כדי לזהות אילו דפים זקוקים לעדכון מבני ואילו זקוקים לעדכוני תוכן מהותיים.
- ארגנו מחדש דפים בעדיפות גבוהה. פתחו קטעים עם תשובות ישירות. הוסיפו אותות ישויות. אמתו את דיוק הנתונים המובנים. אשרו ש-PerplexityBot יכול לגשת לדף.
- שלבו קצב רעננות בלוח העריכה שלכם. קבעו אילו דפים דורשים בדיקה שוטפת ותזמנו את העבודה הזו במפורש במקום להשאירה לתחזוקה ריאקטיבית.
- התחילו מעקב חודשי. נטרו ציטוטי מותג, נראות מתחרים ותנועת הפניות מפלטפורמות AI. מדדו מול קו הבסיס שלכם והתאימו בהתאם למה שתמצאו.
זוהי משמעת תפעולית מתמשכת, לא פרויקט חד-פעמי. ארגונים שבונים יכולת זו — בין אם בתוך הבית ובין אם באמצעות שותף ייעודי — צוברים יתרון מצטבר ככל שאימוץ חיפוש ה-AI ממשיך לצמוח.
שאלות נפוצות
האם אופטימיזציה ל-Perplexity שונה מ-SEO של Google?
באופן חלקי. העקרונות היסודיים — עומק תוכן, בהירות, סמכותיות ונגישות טכנית — חלים על שניהם. ההבדלים המשמעותיים טמונים באופן שבו יש לבנות את התוכן לצורך חילוץ, בתדירות שבה יש לרענן אותו, ובאופן שבו אותות הישות וההיוחסות ממושקלים. הניסוח המדויק ביותר הוא שאופטימיזציה ל-Perplexity היא שכבה אסטרטגית על גבי SEO, לא תחליף לו.
האם התוכן הקיים שלכם ל-SEO עובד עבור Perplexity?
חלקו כנראה כן — במיוחד תוכן שמובנה היטב, עודכן לאחרונה, מיוחס בבירור ונגיש מבחינה טכנית לסורקים. תוכן שמדורג היטב ב-Google עדיין יכול להיות בלתי נראה ל-Perplexity אם תשובות קבורות עמוק בתוך קטעים ארוכים, תאריכי פרסום נעדרים או לא עדכניים, או ש-PerplexityBot אינו יכול לגשת לדף.
מהו PerplexityBot?
PerplexityBot הוא סורק האינטרנט ש-Perplexity משתמשת בו כדי לאחזר תוכן מאתרי אינטרנט. הוא פועל באופן דומה ל-Googlebot בכך שהוא מאחזר דפים מהאינטרנט הפתוח, אך הוא מעריך תוכן בצורה שונה — מתעדף קטעים נפרדים וניתנים לחילוץ על פני דירוג כולל ברמת הדף. אם קובץ robots.txt שלכם חוסם את PerplexityBot, התוכן שלכם לא יופיע בתשובות Perplexity ללא קשר לאיכותו או לסמכותיותו.
כיצד תדעו אם Perplexity מצטטת את התוכן שלכם?
תוכלו לבדוק באופן ידני על ידי הגשת שאלות הרוכשים הרלוונטיות ביותר לעסק שלכם ובדיקה אילו מקורות Perplexity מצטטת בתשובותיה. ניטור שיטתי מחייב תהליך ניתן לחזרה — מעקב אחר נוכחות הציטוט של המותג שלכם לאורך סט שאילתות עקבי לאורך זמן והשוואה מול מתחרים. ניטור ציטוטים הוא אחד המרכיבים המרכזיים של שירות מעקב הנראות החודשי של CiteHarbor.
האם אתם זקוקים לתוכן שונה עבור Perplexity לעומת ChatGPT?
לא תוכן שונה לחלוטין, אך הדגש משתנה בהתאם לפלטפורמה. Perplexity מבצעת שאילתות באינטרנט החי בזמן אמת עבור כל תגובה. המודל הבסיסי של ChatGPT שואב מנתוני אימון, אם כי ChatGPT Search גם מבצע אחזור חי. שניהם מתגמלים תוכן מובנה היטב, סמכותי ומיוחס בבירור — אך Perplexity מעניקה משקל נראה יותר לעדכניות ולהיוחסות המקור. תוכנית נראות AI מתוכננת היטב מטפלת בשניהם מבלי לדרוש מלאי תוכן נפרד עבור כל פלטפורמה.
באיזו תדירות עליכם לעדכן תוכן לצורך נראות ב-Perplexity?
אין כלל אוניברסלי, אך סטנדרט עבודה סביר הוא: בתדירות שבה המידע הבסיסי משתנה באופן משמעותי, ולפחות אחת לרבעון עבור הדפים בעלי העדיפות הגבוהה ביותר שלכם. עדכונים צריכים לשקף עבודה עריכתית אמיתית — מידע מעודכן, דוגמאות עכשוויות, נתונים מחודשים — ולא התאמות תאריך קוסמטיות. מכיוון ש-Perplexity מציג לגולשים תאריכי עדכון, חותמת זמן עדכנית בשילוב עם תוכן מהותי ועכשווי יוצרת יתרון נראות ברור מול מתחרים שדפיהם מיושנים.
מהו GEO והאם הוא זהה לאופטימיזציה של Perplexity?
GEO — Generative Engine Optimization — מתייחס לפרקטיקה הרחבה יותר של מבנה תוכן לשיפור הנראות במנועי חיפוש ומענה מבוססי בינה מלאכותית. אופטימיזציה של Perplexity נכללת בקטגוריית GEO, לצד אופטימיזציה עבור ChatGPT, Google Gemini, Claude ו-Google AI Overviews. העקרונות הבסיסיים חופפים באופן מהותי בין הפלטפורמות השונות, אם כי לכל אחת מהן מאפיינים התנהגותיים שכדאי להבין בנפרד.
הגרסה הקצרה
אינכם זקוקים לאסטרטגיית תוכן נפרדת עבור Perplexity. אתם זקוקים לגרסה מדויקת יותר של האסטרטגיה שכבר יש לכם — כזו שמתחשבת באופן שבו מנועי מענה מבוססי בינה מלאכותית אוחזרים, מעריכים ומייחסים תוכן באופן שונה מחיפוש מסורתי. ההתאמות הנדרשות הן ספציפיות: מיקום תשובות, משמעת עדכניות, אותות ישויות, טרגוט שאלות קונים, וספציפיות שניתנת לציטוט. התוצאות מדידות: תדירות ציטוט המותג, פערי נראות מול מתחרים, ותנועת הפניות מפלטפורמות בינה מלאכותית. האתגר התפעולי הוא אמיתי: עבודה זו דורשת ביצוע עקבי לאורך מחקר, תוכן, פרסום, מעקב ודיווח.
אם הצוות שלכם כבר מתוח על פני SEO, מדיה ממומנת וייצור תוכן, הטמעת נראות בינה מלאכותית כזרם עבודה פנימי נוסף לרוב אינה ריאלית. CiteHarbor נבנה במיוחד למצב הזה — לנהל את הביצוע המלא כך שתקבלו תמונת ביצועים חודשית ממותגת במקום פלטפורמה נוספת להתחבר אליה.
התחילו את תקופת הניסיון החינמית שלכם לשבועיים — ללא צורך בכרטיס אשראי.