מדוע Perplexity מצטטת אתרים חיצוניים במקום דפי החברה שלכם
תוהים מדוע Perplexity מצטטת אתרי סקירות או פרסומים מקצועיים בתעשייה במקום האתר שלכם? מאמר זה מסביר את הגורמים הטכניים, התוכניים ואמינות המקורות העומדים מאחורי בחירת הציטוטים, וכיצד צוותי שיווק יכולים לשפר את הנראות של הארגון שלהם במנועי בינה מלאכותית.
מדוע Perplexity מצטט אתרים של צד שלישי במקום את הדפים של החברה שלכם
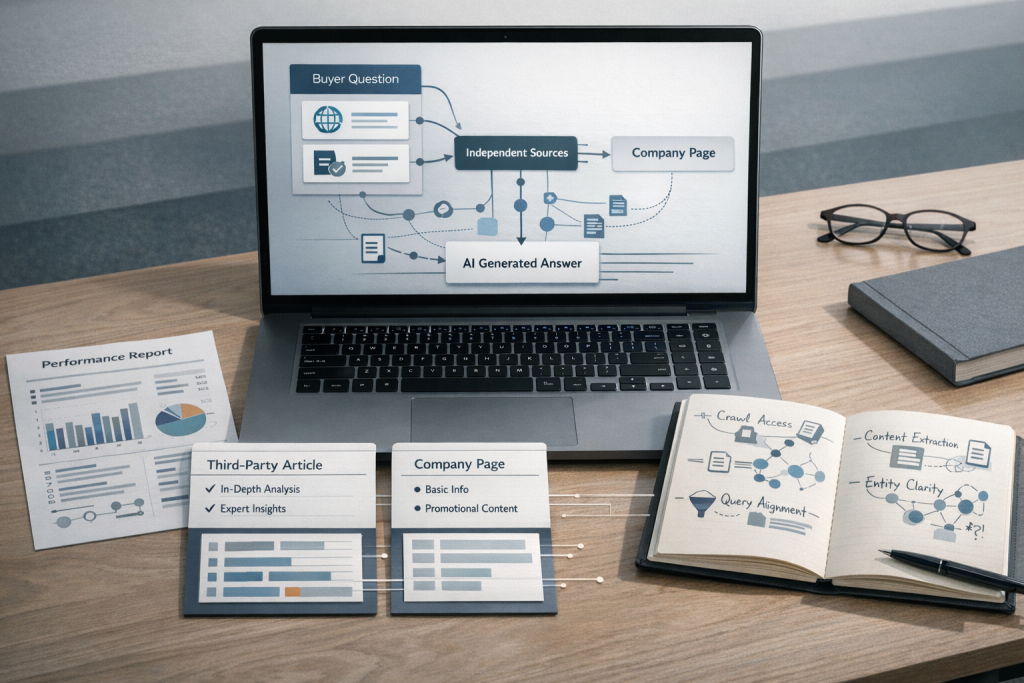
Perplexity אינו תקול כאשר הוא מציג אתר ביקורות, פרסום מקצועי בתעשייה, או בלוג של מתחרה לפני דף החברה שלכם. הוא עושה בדיוק את מה שתוכנן לעשות: לאתר, לצלב ולסנתז את התוכן המפורש ביותר, הנתמך באופן עצמאי ונגיש מבחינה מבנית, הזמין באותו רגע. הדף שלכם נופל לעתים קרובות בלפחות אחד מהקריטריונים הללו, ומאמר זה מסביר היכן נוטים הפערים להופיע ומה תוכלו לעשות כדי לסגור אותם.
אם אתם מנהלי שיווק, מנהלי SEO, או משווקי מוצרי B2B, וחיפשתם את הקטגוריה שלכם ב-Perplexity וצפיתם במקור של צד שלישי תופס את המקום שבו המותג שלכם אמור להיות — זהו ההסבר שחיפשתם. נסקור כיצד תהליך האחזור של Perplexity פועל בפועל, חמשת הסיבות הנפוצות ביותר לכך שהדפים שלכם נדחים, רצף אבחוני לזיהוי איזו סיבה רלוונטית למצבכם, והצעדים המעשיים שמשפרים את הסיכוי שלכם לקבל ציטוט — מבלי להגזים לגבי מה שכל שינוי תוכן יכול להבטיח.
כיצד Perplexity מחליט בפועל מה לצטט
זהו מנוע סינתזה בזמן אמת, לא מדריך
Perplexity אינו שומר רשימה קבועה של אתרים מאושרים לסבב ביניהם בעת מענה לשאלות. בכל פעם שמשתמש מגיש שאילתה, המערכת מבצעת חיפוש אינטרנט חי, שולפת קבוצת דפים מועמדים, מעריכה אותם ביחס לשאלה, ומרכיבה תשובה הנשענת על המקורות שתומכים בצורה הטובה ביותר בתגובה ברורה ואמינה.
פירוש הדבר הוא שציטוט מושג לכל שאילתה בנפרד, ואינו מוקצה למותג. החברה שלכם עשויה לקבל ציטוט לשאלה אחת בנושא הקטגוריה שלכם ולהיות נעדרת לחלוטין משאלה אחרת, בהתאם למה ש-Perplexity שולף, עד כמה התוכן שלכם תואם את השאלה הספציפית, ואם דפים מתחרים עושים עבודה טובה יותר במסירת התשובה בפורמט שהמערכת יכולה לנתח ולהשתמש בו.
חשבו על כך פחות כעל מדריך עסקי ויותר כעל אנליסט מחקר שמביא מקורות טריים לכל שאלה שהוא מקבל. אותו אנליסט אינו מתעניין במי שבבעלותו המידע — הוא רוצה את הדף שעונה על השאלה בצורה הישירה ביותר ואת המקורות שיכולים לאשר זה את זה.
בעלות על החברה אינה הופכת את הדף שלכם למקור ברירת המחדל
כאן רוב העסקים נתקלים בתסכול. אתם מכירים את החברה שלכם, את המוצר שלכם ואת השירות שלכם טוב מכל אחד אחר. נראה הגיוני שהדף שלכם יהיה המקור העיקרי. אך Perplexity אינו שואל איזה ארגון בעל הידע העמוק ביותר לגבי מותג מסוים. הוא שואל אילו דפים הניתנים לאחזור עונים על שאלה ספציפית בצורה המפורשת ביותר, ואילו מקורות מפחיתים את ההסתברות שהתשובה שנוצרה שגויה.
השיקול השני הזה — צמצום הסיכון לתשובה שגויה — הוא הקריטי. מערכות AI המייצרות תגובות ממקורות רשת חיים מתמודדות עם אתגר מתמשך: הן עשויות לייצר תשובות שנשמעות בטוחות אך מכילות שגיאות עובדתיות. כדי לנהל סיכון זה, מערכות כמו Perplexity מעדיפות מקורות המציעים אישור עצמאי, הצהרות עובדתיות מפורשות ותוכן מובנה שניתן לנתח ללא דו-משמעות. דף החברה שלכם, ללא קשר לסמכותיות שהצוות שלכם יודע שיש לו, עשוי שלא לעמוד בקריטריונים הללו טוב כמו סקירת צד שלישי מובנית היטב או פרסום בתעשייה המציין ומשווה עובדות קטגוריה ישירות.
חמישה טעמים לכך שדף צד שלישי מצוטט במקום שלכם
כאשר אנו מבצעים ביקורות נראות AI ללקוחות ב-CiteHarbor, אותן חמש סיבות מופיעות באופן עקבי מאחורי ציטוטי צד שלישי המחליפים את דפי המותג עצמם. רוב העסקים מתמודדים עם יותר מאחת מהן בו-זמנית.
1. הדפים שלכם קשים יותר לאחזור
לפני שמערכת Perplexity יכולה לצטט את הדף שלכם, הסורק שלה — הנקרא PerplexityBot — חייב להיות מסוגל להגיע אליו. אם קובץ robots.txt שלכם חוסם את PerplexityBot ישירות, או אם הוא משתמש בכללי חסימה רחבים הכוללים סורקי AI, הדפים שלכם בלתי נראים למערכת ללא קשר לאיכותם. אף רמה של מצוינות תוכן אינה משנה אם הסורק אינו יכול לגשת לדף מלכתחילה.
מעבר ל-robots.txt, מכשולים טכניים המונעים אחזור כוללים:
- דפים המסתמכים במידה רבה על עיבוד JavaScript, אותו כמה סורקי AI אינם יכולים לעבד במלואו
- זמני תגובה איטיים של השרת הגורמים לסורק לחרוג מהזמן הקצוב או להוריד את הדף בסדר העדיפויות
- חומות כניסה, חומות תשלום, או מסכי ביניים החוסמים את הסורק מהגעה לתוכן הראשי
- תגיות Noindex שנוספו למטרות SEO מסורתיות המורות גם לסורקי AI לדלג על הדף
אתר צד שלישי המכסה את אותו נושא עם דף מהיר, הניתן לסריקה וגלוי לציבור, ייאחזר בעוד שהדף שלכם נמצא מאחורי מחסום טכני שייתכן שאינכם מודעים לקיומו.
2. התוכן שלכם קשה יותר לחילוץ
Perplexity אינה קוראת את הדף שלכם כפי שמבקר אנושי עושה. היא מנתחת את הדף לאיתור הצהרות מפורשות ומובנות שתוכל להשתמש בהן לבניית תשובה. כאשר הדף שלכם נסמך על שפת שיווק מעורפלת, בלוקים נרטיביים ארוכים ללא טענות עובדתיות ברורות, או מסגרת קידומית המתחמקת מהצהרות ישירות, למערכת יש מעט מה להשתמש בו בפועל.
שקלו את ההבדל בין שתי דרכים להצגת אותו מידע:
| דף חברה טיפוסי | אתר ביקורות של צד שלישי |
|---|---|
| “אנו מספקים פתרונות מובילים בתעשייה המסייעים לעסקים למצות את הפוטנציאל המלא שלהם.” | “Company X מציעה שלוש רמות תמחור החל מ-$49 לחודש, עם דיווח אוטומטי, גישת API ותקופת ניסיון חינמית של 14 ימים כלולה.” |
| “הצוות המנוסה שלנו מביא מומחיות עמוקה לכל התקשרות עם לקוח.” | “Company X הושקה ב-2018 ומשרתת כיום כ-2,000 לקוחות B2B בתחומי הייצור והלוגיסטיקה.” |
דף הצד השלישי מציג עובדות קונקרטיות וניתנות לאימות. דף החברה מעלה טענות שקשה לאשר ושכמעט בלתי אפשרי עבור מערכת בינה מלאכותית לצטט בתוך תשובה מסונתזת. Perplexity בוחר את הדף שנותן לו משהו ספציפי לעבוד איתו.
אנו מכנים זאת קלות סינתזה — מידת המאמץ שמערכת בינה מלאכותית חייבת להשקיע כדי להמיר את התוכן שלכם לרכיב תשובה שמיש. דפים בעלי קלות סינתזה גבוהה פותחים בהצהרות מפורשות, משתמשים בהגדרות ברורות, עושים שימוש בכותרות מובנות, ומציבים את התשובה לפני ההסבר. דפים בעלי קלות סינתזה נמוכה קוברים את מהותם בתוך שפה פרסומית או נרטיב לא מובנה.
3. הטענות שלכם אינן מאוששות באופן עצמאי
כאשר דף החברה שלכם קובע כי אתם האפשרות החזקה ביותר בקטגוריה שלכם, מדובר בטענה ממקור ראשון שלא אומתה. כאשר פרסום תעשייתי או פלטפורמת השוואה קובעים כי החברה שלכם דורגה בראש בהערכה ספציפית בקרב קבוצה מוגדרת של ספקים, מדובר בטענה ממקורות עצמאיים.
Perplexity — כמו רוב מערכות סינתזת הבינה המלאכותית — מעדיף מקורות המפחיתים את הסבירות ליצירת תשובה שגויה. אישוש עצמאי הוא אחד האותות הברורים ביותר הזמינים לצורך זה. כאשר מספר דפי צד שלישי מסכימים על עובדה, אותה עובדה הופכת בטוחה יותר עבור המערכת לכלול בתשובתה. כאשר רק דף החברה שלכם מעלה טענה ואין מקור חיצוני שמאשש אותה, המערכת מתייחסת לאותה טענה כפחות אמינה — ללא קשר לשאלה האם היא מדויקת.
אין זה פגם עיצובי. זוהי תגובה סבירה לאתגר של יצירת תשובות אמינות מרשת רועשת ולא אחידה. התוצאה המעשית היא שעסקים ללא שכבה משמעותית של כיסוי צד שלישי — ביקורות, רישומי ספריות, אזכורים בעיתונות, מאמרי השוואה, הפניות תעשייתיות — נמצאים בנחיתות מבנית בתשובות שנוצרו על ידי בינה מלאכותית.
4. סוג השאילתה מעדיף מקורות עצמאיים
לא כל השאילתות מוערכות באותה דרך כאשר Perplexity בוחר מקורות. הבחנה זו חשובה יותר ממה שרוב העסקים מכירים.
שאילתות עובדתיות מבקשות מידע ספציפי: מה חברה עושה, היכן היא ממוקמת, מתי היא נוסדה. עבור אלה, האתר שלכם הוא מועמד חזק משום שאתם המקור הראשוני של מידע מדויק על העסק שלכם.
שאילתות הערכתיות לשפוט: איזה ספק הוא הטוב ביותר לתרחיש שימוש נתון, האם כלי מסוים שווה את עלותו. עבור שאילתות אלה, Perplexity מעדיפה באופן פעיל מקורות עצמאיים, מכיוון שהשאלה דורשת הערכה שדף חברה אינו יכול לספק באופן אמין לגבי עצמה. אף אחד אינו מצפה שאתר של ספק ימליץ על מוצר מתחרה עבור המצב הספציפי של קונה.
שאילתות הסבריות מבקשות הבנה: כיצד תהליך עובד, מדוע תוצאה מסוימת מתרחשת. עבור שאילתות אלה, Perplexity מחפשת דפים המסבירים מושג בבהירות ובאופן ישיר, ללא קשר למי שפרסם אותם. פוסט בנוי היטב מאת איש מקצוע בתעשייה יכול להתעלות על בסיס הידע של החברה עצמה, אם הוא מפורש יותר וקל יותר לניתוח.
עבור שירותי B2B, שירותים מקצועיים ומוצרי SaaS, רוב שאילתות הקונים בעלות הערך הגבוה נוטות להיות הערכתיות. אם זה מתאר את הקטגוריה שלכם, הדפים שלכם עצמם פחות סביר שיצוטטו מבחינה מבנית — לא בגלל שעשיתם משהו לא נכון, אלא בגלל אופן הטיפול של המערכת בסוג שאילתה זה מתוך כוונת עיצוב. הכרת סוגי השאילתות החשובים ביותר בתחום שלכם משנה את האסטרטגיה באופן ניכר.
5. אותות הישות שלכם אינם ברורים
Perplexity צריכה לקבוע מה החברה שלכם היא, מה היא עושה, היכן היא פועלת, מה היא מציעה, וכיצד היא מתחברת לישויות אחרות בקטגוריה שלכם. אם האתר שלכם אינו מציין את הדברים הללו בבירור, המערכת אינה יכולה לשייך את הדפים שלכם בביטחון לשאילתות הרלוונטיות.
בהירות ישות פירושה שהאתר שלכם מזהה באופן עקבי ומפורש:
- את שם החברה שלכם, בצורה המדויקת שבה הוא אמור להופיע בציטוטים
- את המוצרים או השירותים העיקריים שלכם, המתוארים בשפה פשוטה וספציפית
- את אזור השירות הגיאוגרפי שלכם, במידה שרלוונטי
- את התעשייה או הקטגוריה שלכם, הנאמרים ישירות ולא מרומזים דרך הקשר
- את הקשרים שלכם לישויות אחרות — פלטפורמות, שותפים, הסמכות, איגודי תעשייה
כאשר האותות הללו מעורפלים, לא עקביים, או מפוזרים בדפים ללא מבנה ברור, Perplexity עלולה להיכשל בזיהוי האתר שלכם כמקור הסמכותי לשאילתות הנוגעות למותג שלכם עצמו. ספריית צד שלישי המפרטת את שם החברה שלכם, הקטגוריה, המיקום ותיאור השירות בפורמט מובנה יכולה להפוך למקור ש-Perplexity משתמשת בו כדי לענות על שאלה הנוגעת לעסק שלכם עצמו.
אבחון מעשי: איזו סיבה רלוונטית לכם?
רוב העסקים המתמודדים עם ציטוט ירוד ב-Perplexity מתמודדים עם יותר מבעיה אחת, אך זיהוי נקודת ההתחלה הנכונה חוסך זמן ומונע מאמץ שמושקע בתיקונים שאינם מטפלים בבעיה האמיתית. עברו על השאלות הללו לפי הסדר:
- האם PerplexityBot יכול לגשת לדפים שלכם? סקרו את קובץ robots.txt שלכם. אם הוא מציין את PerplexityBot בכלל חסימה, או אם כללי חסימה רחבים חוסמים למעשה את סורקי ה-AI מגישה לתכנים שלכם, זהו הדבר הראשון לתיקון. שום דבר בהמשך לא ישתפר עד שהדפים שלכם יהיו ניתנים לאחזור בפועל.
- האם התכנים שלכם מעלים טענות מפורשות ועובדתיות? פתחו את דפי המוצר או השירות החשובים ביותר שלכם וקראו את שתי הפסקאות הראשונות. אם הן מורכבות בעיקר ממשפטים כמו “ברמה עולמית”, “מוביל בתעשייה” או “מהימן על ידי עסקים בכל מקום” ללא עובדות ספציפיות המצורפות אליהם, לתכנים שלכם יש בעיית קלות סינתזה.
- האם מקורות חיצוניים מאשררים את מה שאתם טוענים? חפשו את שם החברה שלכם בפלטפורמות ביקורות, ספריות תעשייה ואתרי השוואה הרלוונטיים לקטגוריה שלכם. אם תמצאו כיסוי דל או כלל לא של צד שלישי, יש לכם פער אישרור שמקשה על מערכות AI לצטט אתכם בביטחון.
- אילו סוגי שאילתות שולטים בקטגוריה שלכם? הגישו את חמשת השאלות המובילות שהקונים שלכם שואלים לפני בחירת ספק ישירות ל-Perplexity. אם רוב השאילתות הללו הן הערכתיות ולא עובדתיות, האסטרטגיה שלכם צריכה להדגיש בניית נוכחות של צד שלישי ויצירת תכנים שמתייחסים לשאלות הערכתיות עם מהות אמיתית.
- האם האתר שלכם מציין בבירור מהו העסק שלכם ומה הוא עושה? בדקו האם דף הבית, דף ‘אודות’ ודפי השירות הראשיים שלכם מציינים במפורש את שם החברה שלכם, מתארים את השירותים שלכם במונחים קונקרטיים ומזהים את הקטגוריה ואזור השירות שלכם. אם המידע הזה מרומז ולא מצוין, יש לכם בעיית בהירות ישות.
האבחון הזה אינו דורש כלים מיוחדים. הוא דורש קריאה כנה של התכנים שלכם. ב-CiteHarbor, כאשר אנו מתחילים ביקורת נראות AI עבור לקוח חדש, אלו הם מהדברים הראשונים שאנו בוחנים — לצד ניתוח רחב יותר של אילו שאלות קונים המותג מופיע עבורן, אילו שאלות מחזירות את המתחרים במקום, והיכן קיימים פערי הציטוט המשמעותיים ביותר ב-ChatGPT, Perplexity, Gemini, Claude ו-Google AI Overview.
מה אתם יכולים לעשות בנוגע לזה בפועל
תקנו את גישת הסריקה קודם כל
זהו השלב המכני ביותר וזה שיש לו את יחסי הסיבה-ותוצאה הישירים ביותר. בדקו את קובץ robots.txt שלכם וודאו ש-PerplexityBot אינו מופיע בכלל חסימה. אם הוספתם בעבר הגבלות רחבות על סורקי AI — צעד שעסקים רבים נקטו בתקופת חוסר הוודאות הראשונית לגבי נתוני האימון של AI — ייתכן שבטעות הפכתם את המותג שלכם לבלתי נראה למערכות חיפוש AI לחלוטין.
בעת בדיקת גישת הסריקה, ודאו גם שהדפים החשובים ביותר שלכם נטענים במהירות, מספקים את תכניהם ב-HTML סטנדרטי במקום להסתמך על ביצוע JavaScript, ואינם חסומים על ידי מסכות ביניים או הנחיות כניסה המונעות מסורקים להגיע לתוכן הליבה.
כתבו מחדש לצורך יכולת חילוץ, לא רק קריאות
הדפים שלכם עדיין צריכים לעבוד עבור קוראים אנושיים — דרישה זו אינה משתנה. אך הם גם צריכים להיות שמישים עבור מערכות בינה מלאכותית הסורקות עובדות הניתנות לחילוץ. בפועל, המשמעות היא:
- פתיחת כל קטע בהצהרה ישירה במקום בניית הטיעון בהדרגה
- החלפת טענות מעורפלות בעובדות ספציפיות וניתנות לאימות בכל מקום שאפשר
- כתיבת כותרות המתארות את התוכן בפועל של כל קטע
- הגדרת השירותים והמוצרים שלכם במונחים קונקרטיים במקום בשפה שאיפתית
- הצגת מידע השוואתי או מידע על תכונות בפורמטים הניתנים לסריקה בקלות — פסקאות תמציתיות, רשימות עם תוויות, טבלאות במקום שבו הן מבהירות באמת
המטרה אינה כתיבה מכנית. מדובר בכתיבה שברורה דיה כדי שמכונות יוכלו לנתח אותה ולצטט אותה במדויק. תוכן העומד ברף זה נוטה גם לשרת את הקורא האנושי המחפש תשובה ישירה, מבלי לעבור דרך כמה פסקאות של הקדמה כדי למצוא אותה.
בנו את שכבת האישוש החיצוני
אם לחברה שלכם נוכחות מוגבלת של צדדים שלישיים ברשת, שיפור האתר שלכם בנפרד לא יסגור את פער הציטוט. אתם זקוקים למקורות עצמאיים המאשרים את קיומכם, מתארים את ההצעות שלכם, ובאופן אידיאלי מעריכים את הביצועים שלכם.
כיצד זה נראה תלוי בתעשייה שלכם:
- עבור B2B SaaS: פלטפורמות ביקורת תוכנה, ספריות שותפי אינטגרציה, סקירות השוואה בפרסומים מקצועיים בתעשייה
- עבור שירותים מקצועיים: ספריות איגודים מקצועיים, ספריות עסקים, אזכורים בתקשורת המסחרית
- עבור עסקים מקומיים ואזוריים: Google Business Profile, ספריות ספציפיות לתעשייה, סיקור בתקשורת המקומית, מאגרי ביקורות
המטרה אינה לייצר ביקורות מזויפות או לרכוש מיקומים. המטרה היא להבטיח שכאשר מערכת בינה מלאכותית מחפשת ברחבי הרשת מידע על החברה שלכם, היא מוצאת תיאורים עקביים ועובדתיים ממספר מקורות עצמאיים. עקביות מבוזרת זו היא מה שמעניק למערכות בינה מלאכותית את הביטחון לצטט אתכם.
הבהירו את אותות הישות שלכם באתר
ודאו שהאתר שלכם מציין, ב-HTML הניתן לסריקה, את העובדות המהותיות על העסק שלכם. הדבר כולל יישום של Organization schema, Article schema וסוגי נתונים מובנים אחרים במקומות שבהם הם מיושמים בדייקנות. אך נתונים מובנים לבדם אינם מספיקים — טקסט הדף הגלוי גם הוא חייב לתקשר בצורה ברורה ועקבית מי אתם, מה אתם עושים והיכן אתם פועלים.
מבחן פשוט: אם מישהו ללא ידע מוקדם על החברה שלכם יקרא את דף הבית שלכם ואת שלושת דפי השירות המובילים שלכם, האם יוכל לכתוב תיאור של שתי משפטים הכולל את שם החברה, הקטגוריה, השירות העיקרי ואזור השירות שלכם? אם לא, אותות הישות שלכם זקוקים לתשומת לב.
מה שאינכם יכולים לשלוט בו — ומדוע זה חשוב
גם לאחר טיפול בכל הנושאים שצוינו לעיל, ישנם היבטים בהתנהגות הציטוט של Perplexity שנותרים מחוץ לשליטת כל עסק. בחירת המקורות כוללת אחזור בזמן אמת, הצלבת מידע בין מספר עמודים, והחלטות סינתזה שאינן שקופות או ניתנות לשחזור במלואן. אותה שאילתה שהוגשה בימים שונים עשויה להחזיר מקורות מצוטטים שונים.
סוגי שאילתות מסוימים — בפרט שאלות הערכתיות והשוואתיות — יעדיפו באופן עקבי מקורות עצמאיים כעניין של עיצוב. זו אינה בעיה לפתרון; זוהי הדרך שבה מערכות סינתזה של AI מגנות על דיוק תשובותיהן. קבלת מציאות זו מסיטה את השאלה מכיצד לכפות תוצאת ציטוט ספציפית לכיצד להבטיח שהמותג שלכם גלוי, מתואר בדיוק ומגובה היטב בין המקורות ש-Perplexity סביר שיאחזר.
השאלה השנייה הזו מובילה לפרקטיקה עמידה יותר — כזו הבנויה סביב איכות תוכן אמיתית ונוכחות רחבה של צד שלישי, ולא סיבוב יחיד של תיקונים טכניים.
ההבדל בין הכללה באינדקס לבין ציטוט
נקודה שלעתים קרובות מפוספסת בדיונים בנושא זה: נגישות לסורק וציטוט בתשובה אינם אותו הדבר. העמודים שלכם יכולים להיות פתוחים לחלוטין ל-PerplexityBot, נגישים מבחינה טכנית, ועדיין לא להופיע אף פעם כמקור מצוטט.
אינדוקסציה משמעה שהמערכת מודעת לקיום העמוד שלכם ויכולה למשוך אותו כמועמד. ציטוט משמעה שהמערכת בחרה בעמוד שלכם — מבין כל המועמדים שאחזרה — כמקור הראוי להפניה בתשובה ספציפית. המרחק בין שתי התוצאות הללו הוא המקום שבו איכות התוכן, בהירות המבנה, אישוש ויישור לסוג השאילתה עושים את עבודתם.
הבחנה זו חשובה מכיוון שעסקים רבים עוצרים בשכבה הטכנית. הם מאמתים שה-robots.txt שלהם נקי, שהעמודים שלהם נטענים ללא שגיאות ושהאתר שלהם נגיש — ואז מתייחסים לבעיה כפתורה. אך גישה טכנית היא נקודת הכניסה, לא היעד. השאלה האמיתית היא האם התוכן שלכם, לאחר שאוחזר, נותן ל-Perplexity סיבה לבחור בו על פני כל מועמד אחר בקבוצת האחזור הזו.
מדוע הדבר מחייב גישה שונה מ-SEO מסורתי
אם תוכנית ה-SEO הנוכחית שלכם מתמקדת בדירוגי מילות מפתח, רכישת קישורים וקצב פרסום עקבי, ייתכן שהיא אינה מטפלת כלל בנראות הציטוט של AI. SEO מסורתי ואופטימיזציית ציטוט AI חולקים קרקע משותפת מסוימת — יכולת סריקה, מבנה אתר, איכות תוכן — אך מתפצלים בדרכים שחשובות.
הבדלים מרכזיים:
- SEO מסורתי מבצע אופטימיזציה לעמדת דירוג. נראות ציטוט AI עוסקת בשאלה האם התוכן שלכם נבחר כמקור בתשובה מסונתזת — סוג שונה מהותית של החלטת בחירה.
- SEO מסורתי מתמקד במונחי מילות מפתח. נראות הציטוט ב-AI תלויה בשאלה האם התוכן שלכם עונה ישירות על השאלות הספציפיות שקונים מפנים למערכות ה-AI, בשפה שאותן מערכות יכולות לחלץ ולהשתמש בה.
- SEO מסורתי עוקב אחר תנועה ודירוגים. נראות הציטוט ב-AI מחייבת ניטור של אילו פלטפורמות AI מזכירות את המותג שלכם, עבור אילו שאילתות, וכיצד זה משתווה למתחרים — נתונים שרוב לוחות המחוונים של SEO אינם לוכדים.
- תוכן SEO מסורתי יכול להיות פרסומי. מערכות AI מעדיפות באופן עקבי תוכן שהוא הסברתי, עובדתי ובר-אימות עצמאי על פני תוכן שנקרא כחומר שיווקי.
זה לא הופך את ה-SEO המסורתי ללא-רלוונטי. המשמעות היא שנראות הציטוט ב-AI היא דיסציפלינה מקבילה עם דרישות מחקר משלה, גישת תוכן משלה ומסגרת מדידה משלה. עסקים שמתייחסים אליה כהרחבה של שירות ה-SEO הקיים שלהם ימשיכו למצוא אתרי צד שלישי מצוטטים במקומם.
כיצד CiteHarbor מתמודדת עם בעיה זו
ב-CiteHarbor, בנינו את השירות כולו סביב המציאות שמאמר זה מתאר. אנחנו לא מוסרים לכם לוח מחוונים ומשאירים אתכם להבין את נראות ה-AI בעצמכם. אנחנו מנהלים את התהליך המלא.
זה מתחיל עם ביקורת נראות AI ברחבי ChatGPT, Perplexity, Gemini, Claude ו-Google AI Overview — לקביעת היכן המותג שלכם מופיע כרגע, היכן הוא נעדר, אילו שאלות קונים יוצרות את הפערים הגדולים ביותר, ואילו מתחרים מוצגים במקומו. קו בסיס זה מעניק לכם תמונה ברורה של מצב הדברים לפני שמתחילה כל עבודת תוכן.
משם, אנחנו מבצעים מחקר שאלות קונים — לא מחקר מילות מפתח במובן המקובל, אלא ניתוח מובנה של השאלות הממשיות שלקוחות הפוטנציאליים שלכם מגישים למערכות AI כאשר הם משווים ספקים, מעריכים אפשרויות, או מנסים להבין בעיה שהעסק שלכם פותר. שאלות אלו מניעות כל פיסת תוכן שאנחנו יוצרים.
לאחר מכן, אנחנו מייצרים תוכן ממוקד שנבנה לענות על שאלות הקונים האלה תוך שימוש בסוג הכתיבה המפורשת, המובנית וניתנת לחילוץ שמערכות AI יכולות לנתח ולצטט. כל מאמר מתפרסם ישירות לאתר ה-WordPress שלכם ומופץ דרך הערוצים החברתיים שלכם. אתם לא מנהלים פרילנסרים, עוקבים אחר טיוטות בכלי ניהול פרויקטים, או נכנסים לפלטפורמה נפרדת.
כל חודש, אתם מקבלים תמונת מצב ביצועים ממותגת ב-PDF המציגה כיצד נראות ה-AI שלכם השתנתה ביחס לקו הבסיס, אילו שאילתות מציגות כעת את המותג שלכם, וכיצד המתחרים שלכם מתפתחים. אין לוח מחוונים לתחזוקה. אין תוכנה נוספת לאמץ.
המטרה אינה לתמרן מערכות AI לצטט אתכם. המטרה היא לבנות ספריית תוכן בנכסים הדיגיטליים שלכם שמרוויחה ציטוטים — כי היא עונה על שאלות קונים אמיתיות בצורה ברורה ומלאה יותר מהאלטרנטיבות שנאספות כעת.
שאלות נפוצות
האם בעלות על דף החברה שלכם מבטיחה שPerplexity יצטט אותו?
לא. Perplexity בוחר מקורות על בסיס יכולת אחזור, בהירות תוכן ואימות עצמאי — ולא על בסיס מי שמחזיק במותג. הדף שלכם מתחרה כמועמד אחד מבין רבים וחייב להרוויח ציטוט בכך שיהיה מפורש יותר, מובנה יותר וניתן לאימות יותר מדפים אחרים שנאספו לאותה שאילתה ספציפית.
האם ניתן לאלץ את Perplexity לצטט את האתר שלכם?
לא. אין מנגנון להפניית Perplexity לצטט דף ספציפי. תוכלו לשפר את הסיכוי שלכם לקבל ציטוט על ידי הבטחת גישת סריקה לדפים שלכם, מבנה ברור, ביסוס עובדתי ואימות חיצוני — אך החלטות ציטוט מתקבלות על ידי המערכת בזמן אמת ואינן ניתנות לחיזוי או שליטה מלאים.
מדוע Perplexity מצטט אתר ביקורות במקום דף המוצר שלכם?
אתרי ביקורות מכילים בדרך כלל טענות עובדתיות מפורשות, השוואות מובנות והערכות עצמאיות — כל אלה קלים יותר למערכות AI לחלץ ולאמת בהשוואה לתוכן שיווקי של מוצרים. עבור שאילתות הערכה בפרט, Perplexity מעדיף מקורות המציעים שיפוט עצמאי על פני שיווק מהמקור הראשון.
מהו PerplexityBot וכיצד תבדקו אם יש לו גישה לאתר שלכם?
PerplexityBot הוא הסורק של Perplexity. הוא מכבד את פרוטוקול robots.txt כדי לקבוע אילו דפים הוא רשאי לגשת אליהם. תוכלו לבחון את קובץ robots.txt שלכם — הנמצא בדרך כלל בכתובת yourdomain.com/robots.txt — כדי לבדוק אם PerplexityBot חסום במפורש או אם כללי חסימה רחבים מונעים ממנו לסרוק את התוכן שלכם.
האם robots.txt שלכם משפיע על ציטוטים של Perplexity?
כן. אם robots.txt שלכם חוסם את PerplexityBot, הדפים שלכם אינם ניתנים לאחזור או לציטוט. עסקים מסוימים הוסיפו הגבלות רחבות על סורקי AI בתקופת אי-הוודאות הראשונה סביב שימוש בנתוני אימון, והסירו את עצמם שלא בכוונה מנראות חיפוש ה-AI כתוצאה מכך. בדיקה ותיקון של robots.txt שלכם הם אחד הצעדים הטכניים בעלי ההשפעה הגדולה ביותר העומדים לרשותכם.
מדוע Perplexity מצטט את המתחרה שלכם ולא אתכם?
הסיבות הנפוצות ביותר הן שהתוכן של המתחרה שלכם מובנה בצורה מפורשת יותר, נגיש יותר לסורקים, או נתמך טוב יותר על ידי מקורות צד שלישי. ייתכן גם שהתוכן שלהם עונה על שאלות הקונים הספציפיות שPerplexity מאחזר, בעוד שהתוכן שלכם מכסה תחום שונה או משתמש בשפה שקשה יותר לחלץ. ביקורת נראות AI יכולה לאתר את הפערים הספציפיים במצבכם.
האם Perplexity דורש אסטרטגיה נפרדת מפלטפורמות חיפוש AI אחרות?
העקרונות הבסיסיים — גישת סריקה, בהירות תוכן, טענות מפורשות, אימות עצמאי ואותות ישויות — חלים על כל סביבות חיפוש ה-AI המרכזיות. עם זאת, כל פלטפורמה מפעילה סורק משלה, לוגיקת אחזור משלה והתנהגות בחירת מקורות משלה. תרגול נראות AI יסודי עוקב ומייעל על פני פלטפורמות, במקום להתייחס לאחת מהן בלבד כתמונה המלאה.
מה לעשות בשלב הבא
אם המותג שלכם מוחמץ בתשובות Perplexity בעוד שאתרי צד שלישי ומתחרים מופיעים במקומכם, הסיבה כמעט בוודאות נעוצה באחד או יותר מחמשת הגורמים שנסקרו כאן: גישת סריקה, יכולת חילוץ תוכן, אימות עצמאי, התאמת סוג שאילתה או בהירות ישויות. הצעד הראשון הוא אבחון מדויק — זיהוי איזה מגורמים אלה מניע בפועל את המצב שלכם, לפני שתתחייבו לשינויים שעשויים שלא לטפל בבעיה האמיתית.
ביקורת הנראות הראשונית של CiteHarbor ב-AI נועדה לענות בדיוק על שאלה זו. אנו מעריכים את נוכחות הציטוט הנוכחית של המותג שלכם ב-ChatGPT, Perplexity, Gemini, Claude ו-Google AI Overview, מאתרים את שאלות הרוכשים שבהן אתם נעדרים, ומציגים לכם היכן מתחרים מופיעים במקומכם. משם, אנו מנהלים את התוכן, הפרסום, ההפצה והמעקב השוטף — ומספקים לכם תמונה ברורה של מיקומכם ומסלול טיפול קדימה, מבלי להוסיף פלטפורמה נוספת לתהליך העבודה שלכם.
התחילו את תקופת הניסיון החינמית לשבועיים — ללא צורך בכרטיס אשראי.