Pourquoi Perplexity cite des sites tiers plutôt que les pages de votre entreprise
Vous vous demandez pourquoi Perplexity cite des sites d'avis ou des publications sectorielles plutôt que votre propre site web ? Cet article explique les facteurs techniques, éditoriaux et de crédibilité qui déterminent la sélection des citations, ainsi que les leviers dont disposent les équipes marketing pour améliorer leur visibilité dans les réponses des IA.
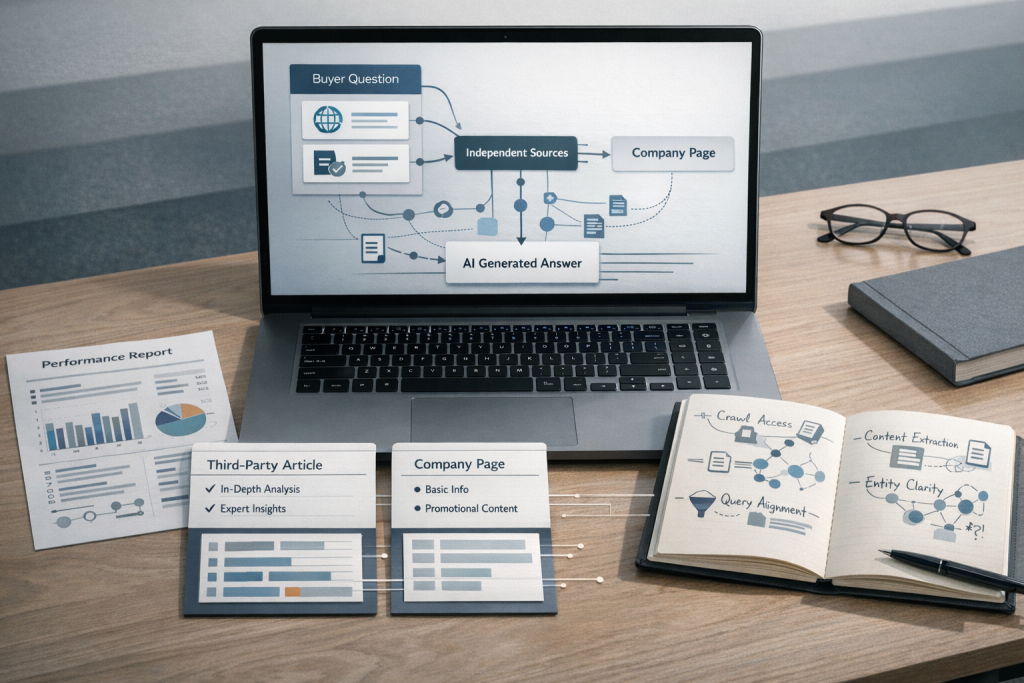
Pourquoi Perplexity cite des sites tiers plutôt que les pages de votre propre entreprise
Perplexity ne dysfonctionne pas lorsqu’il met en avant un site d’avis, une publication sectorielle ou le blog d’un concurrent avant votre page d’entreprise. Il fait précisément ce pour quoi il a été conçu : localiser, recouper et synthétiser le contenu le plus explicite, le plus indépendamment étayé et le plus structurellement accessible disponible à cet instant. Votre page ne répond fréquemment pas à au moins l’un de ces critères, et cet article explique où ces lacunes ont tendance à apparaître et ce que vous pouvez faire pour les combler.
Si vous êtes un responsable marketing, un directeur SEO ou un spécialiste du marketing produit B2B qui a interrogé sa catégorie dans Perplexity et constaté qu’une source tierce occupait la place qui devrait revenir à votre marque, voici l’explication que vous cherchiez. Nous examinerons le fonctionnement réel du processus de récupération de Perplexity, les cinq raisons les plus courantes pour lesquelles vos pages sont écartées, une séquence de diagnostic pour identifier laquelle s’applique à votre situation, ainsi que les étapes pratiques qui améliorent votre probabilité d’être cité — sans surestimer ce que toute modification de contenu peut garantir.
Comment Perplexity décide réellement ce qu’il cite
C’est un moteur de synthèse en temps réel, pas un annuaire
Perplexity ne tient pas une liste figée de sites approuvés qu’il parcourt pour répondre aux questions. Chaque fois qu’un utilisateur soumet une requête, le système effectue une recherche web en direct, récupère un ensemble de pages candidates, les évalue par rapport à la question et assemble une réponse en s’appuyant sur les sources qui étayent le mieux une réponse claire et vérifiable.
Cela signifie que la citation est méritée requête par requête, et non attribuée par marque. Votre entreprise pourrait être citée pour une question relative à votre catégorie et totalement absente pour une autre, selon ce que Perplexity récupère, la correspondance entre votre contenu et la question spécifique, et si les pages concurrentes font un meilleur travail en fournissant la réponse dans un format que le système peut analyser et utiliser.
Pensez-y moins comme un annuaire d’entreprises et davantage comme un analyste de recherche qui récupère des sources fraîches pour chaque question posée. Cet analyste ne s’intéresse pas à qui possède l’information — il veut la page qui répond à la question le plus directement et les sources qui peuvent se confirmer mutuellement.
Être propriétaire de l’entreprise ne fait pas de votre page la source par défaut
C’est là que la plupart des entreprises se heurtent à la frustration. Vous connaissez votre entreprise, votre produit et votre service mieux que quiconque. Il semble logique que votre page soit la référence principale. Mais Perplexity ne se demande pas quelle organisation possède la connaissance la plus approfondie d’une marque donnée. Il se demande quelles pages récupérables répondent le plus explicitement à une question spécifique, et quelles sources réduisent la probabilité que la réponse générée soit incorrecte.
Cette deuxième considération — réduire le risque d’une réponse inexacte — est la plus déterminante. Les systèmes d’IA qui génèrent des réponses à partir de sources web en direct font face à un défi persistant : ils peuvent produire des réponses au ton assuré contenant des erreurs factuelles. Pour gérer ce risque, des systèmes comme Perplexity privilégient les sources offrant une confirmation indépendante, des déclarations factuelles explicites et un contenu structuré pouvant être analysé sans ambiguïté. La page de votre entreprise, quelle que soit l’autorité que lui reconnaît votre équipe, peut ne pas satisfaire ces critères aussi bien qu’un avis tiers soigneusement structuré ou qu’une publication sectorielle qui énonce et compare directement les faits de la catégorie.
Cinq raisons pour lesquelles une page tierce est citée à la place de la vôtre
Lorsque nous réalisons des audits de visibilité IA pour nos clients chez CiteHarbor, les cinq mêmes causes se retrouvent systématiquement derrière les citations de pages tierces qui supplantent les pages propres d’une marque. La plupart des entreprises font face à plusieurs de ces problèmes simultanément.
1. Vos pages sont plus difficiles à récupérer
Avant que Perplexity puisse citer votre page, son robot d’exploration — appelé PerplexityBot — doit pouvoir y accéder. Si votre fichier robots.txt bloque directement PerplexityBot, ou s’il utilise des règles de désactivation larges qui englobent les robots d’exploration IA, vos pages sont invisibles pour le système, quelle que soit leur qualité. Aucun niveau d’excellence du contenu n’a d’importance si le robot d’exploration ne peut pas accéder à la page en premier lieu.
Au-delà de robots.txt, les obstacles techniques qui empêchent la récupération comprennent :
- Les pages qui dépendent fortement du rendu JavaScript, que certains robots d’exploration IA ne peuvent pas traiter entièrement
- Les temps de réponse serveur lents qui amènent le robot d’exploration à expirer ou à déprioritiser la page
- Les murs de connexion, les murs payants ou les écrans interstitiels qui empêchent le robot d’exploration d’atteindre le contenu principal
- Les balises Noindex ajoutées à des fins de référencement traditionnel qui indiquent également aux robots d’exploration IA de passer la page
Un site tiers couvrant le même sujet avec une page rapide, explorable et accessible au public sera récupéré tandis que la vôtre se trouve derrière un obstacle technique dont vous ignorez peut-être l’existence.
2. Votre contenu est plus difficile à extraire
Perplexity ne lit pas votre page comme le ferait un visiteur humain. Il analyse la page à la recherche de déclarations explicites et structurées qu’il peut utiliser pour construire une réponse. Lorsque votre page repose sur un langage marketing vague, de longs blocs narratifs sans affirmations factuelles claires, ou un cadrage promotionnel qui contourne les déclarations directes, le système dispose de peu d’éléments exploitables.
Considérez la différence entre deux façons de présenter la même information :
| Page d’entreprise typique | Site d’évaluation tiers |
|---|---|
| « Nous proposons des solutions de pointe qui aident les entreprises à atteindre leur plein potentiel. » | « La société X propose trois niveaux de tarification à partir de 49 $/mois, avec des rapports automatisés, un accès API et un essai gratuit de 14 jours inclus. » |
| « Notre équipe expérimentée apporte une expertise approfondie à chaque engagement client. » | « Company X a été lancée en 2018 et sert actuellement environ 2 000 clients B2B dans les secteurs de la fabrication et de la logistique. » |
La page tierce présente des faits concrets et vérifiables. La page de l’entreprise formule des affirmations difficiles à confirmer et quasi impossibles à citer pour un système d’IA dans une réponse synthétisée. Perplexity sélectionne la page qui lui fournit quelque chose de précis avec lequel travailler.
Nous appelons cela la facilité de synthèse — le degré d’effort qu’un système d’IA doit déployer pour convertir votre contenu en un élément de réponse exploitable. Les pages à haute facilité de synthèse commencent par des affirmations explicites, utilisent des définitions claires, emploient des titres structurés et placent la réponse avant l’explication. Les pages à faible facilité de synthèse enfouissent leur substance dans un langage promotionnel ou un récit non structuré.
3. Vos affirmations ne sont pas corroborées de manière indépendante
Lorsque la page de votre entreprise affirme que vous êtes la meilleure option dans votre catégorie, il s’agit d’une affirmation de première partie non vérifiée. Lorsqu’une publication sectorielle ou une plateforme de comparaison indique que votre entreprise s’est classée première lors d’une évaluation spécifique parmi un ensemble défini de prestataires, il s’agit d’une affirmation provenant d’une source indépendante.
Perplexity — comme la plupart des systèmes de synthèse par IA — privilégie les sources qui réduisent la probabilité de générer une réponse inexacte. La corroboration indépendante est l’un des signaux les plus clairs disponibles à cet effet. Lorsque plusieurs pages tierces s’accordent sur un fait, ce fait devient plus sûr pour le système à inclure dans sa réponse. Lorsque seule la page de votre entreprise formule une affirmation et qu’aucune source externe ne la confirme, le système traite cette affirmation comme moins fiable — qu’elle soit exacte ou non.
Il ne s’agit pas d’un défaut de conception. C’est une réponse raisonnable au défi que représente la génération de réponses fiables à partir d’un web hétérogène et bruyant. La conséquence pratique est que les entreprises sans une couche significative de couverture tierce — avis, inscriptions dans des annuaires, mentions dans la presse, articles de comparaison, références sectorielles — sont structurellement désavantagées dans les réponses générées par l’IA.
4. Le type de requête favorise les sources indépendantes
Toutes les requêtes ne sont pas évaluées de la même manière lorsque Perplexity sélectionne ses sources. Cette distinction est plus importante que la plupart des entreprises ne le reconnaissent.
Les requêtes factuelles demandent des informations spécifiques : ce que fait une entreprise, où elle est située, quand elle a été fondée. Pour celles-ci, votre propre site web est un candidat solide, car vous êtes la source principale d’informations exactes sur votre activité.
Les requêtes évaluatives ask for judgment: which provider is best for a given use case, whether a particular tool is worth the cost. For these, Perplexity actively favors independent sources because the question calls for an assessment that a company page cannot credibly supply about itself. No one expects a vendor’s website to recommend a competing product for a particular buyer’s situation.
Requêtes explicatives demandent une compréhension : comment un processus fonctionne, pourquoi un résultat particulier se produit. Pour celles-ci, Perplexity recherche des pages qui expliquent un concept clairement et directement, quel qu’en soit l’auteur. Un article bien structuré d’un praticien du secteur peut surpasser la base de connaissances d’une entreprise s’il est plus explicite et plus facile à analyser.
Pour les services B2B, les services professionnels et les produits SaaS, la majorité des requêtes à forte valeur ajoutée des acheteurs tendent à être évaluatives. Si cela décrit votre catégorie, vos propres pages sont structurellement moins susceptibles d’être citées — non pas en raison d’une erreur de votre part, mais en raison de la façon dont le système gère ce type de requête par conception. Reconnaître quels types de requêtes importent le plus dans votre secteur remodèle considérablement la stratégie.
5. Vos Signaux d’Entité Ne Sont Pas Clairs
Perplexity doit établir ce qu’est votre entreprise, ce qu’elle fait, où elle opère, ce qu’elle propose et comment elle se connecte aux autres entités de votre catégorie. Si votre site web n’indique pas ces éléments clairement, le système ne peut pas associer avec confiance vos pages aux requêtes pertinentes.
La clarté de l’entité signifie que votre site identifie de manière cohérente et explicite :
- Le nom de votre entreprise, dans la forme exacte sous laquelle il doit apparaître dans les citations
- Vos produits ou services principaux, décrits dans un langage simple et précis
- Votre zone de service géographique, le cas échéant
- Votre secteur ou catégorie, énoncé explicitement plutôt que suggéré par le contexte
- Vos relations avec d’autres entités — plateformes, partenaires, certifications, associations professionnelles
Lorsque ces signaux sont vagues, incohérents ou dispersés sur plusieurs pages sans structure claire, Perplexity peut ne pas reconnaître votre site comme la source faisant autorité pour les requêtes concernant votre propre marque. Un annuaire tiers qui répertorie le nom, la catégorie, l’emplacement et la description des services de votre entreprise dans un format structuré peut devenir la source que Perplexity utilise pour répondre à une question sur votre propre entreprise.
Un Diagnostic Pratique : Quelle Raison Vous Concerne ?
La plupart des entreprises confrontées à un faible nombre de citations dans Perplexity ont plus d’un problème en jeu, mais identifier le bon point de départ permet de gagner du temps et d’éviter des efforts consacrés à des corrections qui ne traitent pas le problème réel. Parcourez ces questions dans l’ordre :
- PerplexityBot peut-il accéder à vos pages ? Vérifiez votre fichier robots.txt. S’il mentionne PerplexityBot dans une règle d’interdiction, ou si des règles d’interdiction larges empêchent effectivement les robots d’exploration IA d’accéder à votre contenu, c’est le premier point à corriger. Rien en aval ne s’améliorera tant que vos pages ne seront pas effectivement accessibles.
- Votre contenu formule-t-il des affirmations explicites et factuelles ? Ouvrez vos pages de produits ou de services les plus importantes et lisez les deux premiers paragraphes. S’ils se composent principalement de formules comme « de classe mondiale », « leader du secteur » ou « approuvé par les entreprises du monde entier » sans faits spécifiques à l’appui, votre contenu présente un problème de facilité de synthèse.
- Des sources externes corroborent-elles vos affirmations ? Recherchez le nom de votre entreprise sur les plateformes d’avis, les annuaires sectoriels et les sites de comparaison pertinents pour votre catégorie. Si vous trouvez peu ou pas de couverture tierce, vous avez un déficit de corroboration qui rend plus difficile pour les systèmes d’IA de vous citer avec confiance.
- Quels types de requêtes dominent votre catégorie ? Soumettez directement à Perplexity les cinq principales questions que vos acheteurs posent avant de sélectionner un fournisseur. Si la plupart de ces requêtes sont évaluatives plutôt que factuelles, votre stratégie doit mettre l’accent sur le développement d’une présence tierce et la création de contenu qui répond aux questions évaluatives avec une substance véritable.
- Votre site indique-t-il clairement ce qu’est votre entreprise et ce qu’elle fait ? Vérifiez si votre page d’accueil, votre page « À propos » et vos pages de services principales mentionnent explicitement le nom de votre entreprise, décrivent vos services en termes concrets et identifient votre catégorie et votre zone de service. Si ces informations sont implicites plutôt qu’explicitement formulées, vous avez un problème de clarté d’entité.
Ce diagnostic ne nécessite pas d’outils spécialisés. Il requiert une lecture honnête de votre propre contenu. Chez CiteHarbor, lorsque nous commençons un audit de visibilité IA pour un nouveau client, ces éléments figurent parmi les premiers que nous examinons — ainsi qu’une analyse plus large des questions d’acheteurs pour lesquelles la marque apparaît, des questions qui font remonter des concurrents à la place, et des lacunes de citation les plus importantes sur ChatGPT, Perplexity, Gemini, Claude et Google AI Overview.
Ce que vous pouvez concrètement faire à ce sujet
Corrigez l’accès d’exploration en premier
Il s’agit de l’étape la plus mécanique et celle qui présente la relation de cause à effet la plus directe. Vérifiez votre fichier robots.txt et confirmez que PerplexityBot n’est pas répertorié dans une règle d’interdiction. Si vous avez précédemment ajouté des restrictions larges sur les robots d’exploration IA — une mesure prise par de nombreuses entreprises lors des premières incertitudes concernant les données d’entraînement IA — vous avez peut-être rendu votre marque totalement invisible pour les systèmes de recherche IA.
En examinant l’accès d’exploration, confirmez également que vos pages les plus importantes se chargent rapidement, délivrent leur contenu en HTML standard plutôt qu’en dépendant de l’exécution JavaScript, et ne sont pas bloquées par des interstitiels ou des invites de connexion qui empêchent les robots d’exploration d’accéder au contenu principal.
Réécrivez pour l’extractibilité, pas seulement pour la lisibilité
Vos pages doivent toujours fonctionner pour les lecteurs humains — cette exigence ne change pas. Mais elles doivent également être utilisables par les systèmes d’IA qui analysent le contenu à la recherche de faits extractibles. En pratique, cela signifie :
- Ouvrir chaque section par une affirmation directe plutôt que de construire progressivement vers un point
- Remplacer les affirmations vagues par des faits précis et vérifiables dans la mesure du possible
- Rédiger des titres qui décrivent réellement le contenu de la section
- Définir vos services et produits en termes concrets plutôt qu’en langage aspirationnel
- Présenter les informations comparatives ou les caractéristiques dans des formats faciles à parcourir — paragraphes concis, listes étiquetées, tableaux lorsqu’ils apportent une clarté réelle
L’objectif n’est pas une écriture mécanique. C’est une écriture suffisamment claire pour que les machines puissent l’analyser et la citer avec précision. Un contenu qui atteint ce niveau tend également à servir le lecteur humain qui souhaite une réponse directe sans avoir à parcourir plusieurs paragraphes de préambule pour la trouver.
Construire la couche de corroboration externe
Si la présence en ligne de votre entreprise auprès de tiers est limitée, améliorer votre propre site web de manière isolée ne comblera pas le déficit de citation. Vous avez besoin de sources indépendantes qui confirment votre existence, décrivent vos offres et, idéalement, évaluent vos performances.
La forme que cela prend dépend de votre secteur d’activité :
- Pour les SaaS B2B : plateformes d’avis sur les logiciels, annuaires de partenaires d’intégration, couverture comparative dans les publications sectorielles
- Pour les services professionnels : annuaires d’associations professionnelles, annuaires d’entreprises, mentions dans les médias spécialisés
- Pour les entreprises locales et régionales : Google Business Profile, annuaires spécifiques au secteur, couverture dans les médias locaux, agrégateurs d’avis
L’objectif n’est pas de fabriquer de faux avis ni d’acheter des emplacements. L’objectif est de s’assurer que lorsqu’un système d’IA examine le web à la recherche d’informations sur votre entreprise, il trouve des descriptions cohérentes et factuelles provenant de plusieurs sources indépendantes. C’est cette cohérence distribuée qui donne aux systèmes d’IA la confiance nécessaire pour vous citer.
Clarifier vos signaux d’entité sur votre site
Assurez-vous que votre site web indique, dans un HTML explorable par les robots d’exploration, les faits essentiels concernant votre entreprise. Cela inclut la mise en œuvre du schema Organization, du schema Article et d’autres types de données structurées là où ils s’appliquent avec précision. Mais les données structurées seules sont insuffisantes — le texte visible de la page doit également communiquer clairement et de manière cohérente qui vous êtes, ce que vous faites et où vous exercez.
Un test simple : si une personne n’ayant aucune connaissance préalable de votre entreprise lisait votre page d’accueil et vos trois principales pages de services, pourrait-elle rédiger une description en deux phrases incluant le nom de votre entreprise, votre catégorie, votre service principal et votre zone de service ? Dans le cas contraire, vos signaux d’entité nécessitent une attention particulière.
Ce que vous ne pouvez pas contrôler — et pourquoi cela importe
Même après avoir traité tous les problèmes mentionnés ci-dessus, certains aspects du comportement de citation de Perplexity échappent au contrôle de toute entreprise. La sélection des sources implique une récupération en temps réel, des recoupements entre plusieurs pages et des décisions de synthèse qui ne sont pas entièrement transparentes ni reproductibles. La même requête soumise à des jours différents peut renvoyer des sources citées différentes.
Certains types de requêtes — en particulier les questions évaluatives et comparatives — favorisent systématiquement les sources indépendantes, par conception. Ce n’est pas un problème à résoudre ; c’est ainsi que les systèmes de synthèse IA protègent l’exactitude de leurs réponses. Accepter cette réalité déplace la question : il ne s’agit plus de forcer un résultat de citation spécifique, mais de s’assurer que votre marque est visible, décrite avec précision et bien étayée parmi les sources que Perplexity est susceptible de récupérer.
Cette deuxième question mène à une pratique plus durable — fondée sur une véritable qualité de contenu et une large présence tierce, plutôt que sur une série unique de corrections techniques.
La différence entre être indexé et être cité
Un point souvent négligé dans les discussions sur ce sujet : être accessible à un robot d’exploration et être cité dans une réponse ne sont pas la même chose. Vos pages peuvent être entièrement ouvertes à PerplexityBot, techniquement accessibles, et ne jamais apparaître comme source citée.
L’indexation signifie que le système est conscient de l’existence de votre page et peut la récupérer comme candidate. La citation signifie que le système a choisi votre page — parmi tous les candidats récupérés — comme source digne d’être référencée dans une réponse spécifique. L’écart entre ces deux résultats est là où la qualité du contenu, la clarté structurelle, la corroboration et l’alignement sur le type de requête font leur travail.
Cette distinction est importante car de nombreuses entreprises s’arrêtent à la couche technique. Elles vérifient que leur robots.txt est propre, que leurs pages se chargent sans erreurs et que leur site est accessible — puis considèrent le problème comme résolu. Mais l’accès technique est le point d’entrée, non la destination. La vraie question est de savoir si votre contenu, une fois récupéré, donne à Perplexity une raison de le sélectionner par rapport à tous les autres candidats de cet ensemble de récupération.
Pourquoi cela nécessite une approche différente du SEO traditionnel
Si votre programme SEO actuel est centré sur les classements par mots-clés, l’acquisition de liens et une cadence de publication régulière, il peut ne pas du tout traiter la visibilité des citations IA. Le SEO traditionnel et l’optimisation des citations IA partagent certains points communs — la capacité d’exploration, la structure du site, la qualité du contenu — mais divergent de manière significative.
Différences clés :
- Le SEO traditionnel optimise pour la position dans les classements. La visibilité des citations IA concerne la question de savoir si votre contenu est sélectionné comme source dans une réponse synthétisée — un type de décision de sélection fondamentalement différent.
- Le SEO traditionnel cible les termes de mots-clés. La visibilité des citations IA dépend du fait que votre contenu répond directement aux questions précises que les acheteurs adressent aux systèmes IA, dans un langage que ces systèmes peuvent extraire et utiliser.
- Le SEO traditionnel suit le trafic et les classements. La visibilité des citations IA nécessite de surveiller quelles plateformes IA font référence à votre marque, pour quelles requêtes, et comment cela se compare à vos concurrents — des données que la plupart des tableaux de bord SEO ne capturent pas.
- Le contenu SEO traditionnel peut être promotionnel. Les systèmes IA favorisent systématiquement le contenu explicatif, factuel et vérifiable de manière indépendante par rapport au contenu qui s’apparente à du texte marketing.
Cela ne rend pas le SEO traditionnel obsolète. Cela signifie que la visibilité des citations IA est une discipline parallèle avec ses propres exigences de recherche, sa propre approche de contenu et son propre cadre de mesure. Les entreprises qui la traitent comme une extension de leur contrat de prestation SEO existant continueront à trouver des sites tiers cités à leur place.
Comment CiteHarbor aborde ce problème
Chez CiteHarbor, nous avons construit l’intégralité de notre service autour de la réalité décrite dans cet article. Nous ne vous remettons pas simplement un tableau de bord en vous laissant comprendre la visibilité IA par vous-même. Nous gérons l’intégralité du processus.
Cela commence par un audit de visibilité IA sur ChatGPT, Perplexity, Gemini, Claude et Google AI Overview — établissant où votre marque apparaît actuellement, où elle est absente, quelles questions des acheteurs produisent les plus grands écarts, et quels concurrents sont mis en avant à sa place. Cette base de référence vous donne une image claire de la situation avant que tout travail de contenu ne commence.
À partir de là, nous réalisons une recherche sur les questions des acheteurs — non pas une recherche de mots-clés au sens conventionnel, mais une analyse structurée des questions réelles que vos clients potentiels soumettent aux systèmes IA lorsqu’ils comparent des prestataires, évaluent des options ou cherchent à comprendre un problème que votre entreprise résout. Ces questions guident chaque contenu que nous créons.
Nous produisons ensuite un contenu ciblé conçu pour répondre à ces questions des acheteurs en utilisant un type d’écriture explicite, structuré et extractible que les systèmes IA peuvent analyser et citer. Chaque article est publié directement sur votre site WordPress et distribué via vos canaux sociaux. Vous ne gérez pas de freelances, ne suivez pas de brouillons dans un outil de gestion de projet et ne vous connectez pas à une plateforme distincte.
Chaque mois, vous recevez un rapport de performance PDF personnalisé montrant comment votre visibilité IA a évolué par rapport à la base de référence, quelles requêtes mettent désormais en avant votre marque, et comment évoluent vos concurrents. Aucun tableau de bord à maintenir. Aucun logiciel supplémentaire à adopter.
L’objectif n’est pas de manipuler les systèmes d’IA pour qu’ils vous citent. Il s’agit de constituer une bibliothèque de contenu sur vos propres propriétés numériques qui mérite d’être citée — parce qu’elle répond aux questions réelles de vos acheteurs de manière plus claire et plus complète que les alternatives actuellement récupérées.
Questions fréquemment posées
Le fait de posséder la page de mon entreprise garantit-il que Perplexity la citera ?
Non. Perplexity sélectionne les sources en fonction de leur accessibilité, de la clarté du contenu et de la corroboration indépendante — et non en fonction du propriétaire de la marque. Votre page est en concurrence avec de nombreux autres candidats et doit mériter d’être citée en étant plus explicite, plus structurée et plus vérifiable que les autres pages récupérées pour cette requête spécifique.
Puis-je forcer Perplexity à citer mon site web ?
Non. Il n’existe aucun mécanisme permettant d’obliger Perplexity à citer une page spécifique. Vous pouvez améliorer votre probabilité d’être cité en vous assurant que vos pages sont explorables, clairement structurées, fondées sur des faits et corroborées par des sources externes — mais les décisions de citation sont prises par le système en temps réel et ne sont pas entièrement prévisibles ni contrôlables.
Pourquoi Perplexity cite-t-il un site d’avis plutôt que ma page produit ?
Les sites d’avis contiennent généralement des affirmations factuelles explicites, des comparaisons structurées et des évaluations indépendantes — autant d’éléments qu’il est plus facile pour les systèmes d’IA d’extraire et de vérifier que le contenu promotionnel de produits. Pour les requêtes d’évaluation en particulier, Perplexity favorise les sources offrant un jugement indépendant plutôt que du marketing en première partie.
Qu’est-ce que PerplexityBot et comment vérifier s’il peut accéder à mon site ?
PerplexityBot est le robot d’exploration web de Perplexity. Il respecte le protocole robots.txt pour déterminer les pages auxquelles il peut accéder. Vous pouvez consulter votre fichier robots.txt — généralement situé à yourdomain.com/robots.txt — pour vérifier si PerplexityBot est explicitement bloqué ou si des règles de désactivation larges l’empêchent d’explorer votre contenu.
Mon fichier robots.txt affecte-t-il les citations de Perplexity ?
Oui. Si votre robots.txt bloque PerplexityBot, vos pages ne peuvent pas être récupérées ni citées. Certaines entreprises ont ajouté des restrictions larges pour les robots d’exploration d’IA lors des premières incertitudes concernant l’utilisation des données d’entraînement, se retirant ainsi involontairement de la visibilité dans les recherches d’IA. Réviser et corriger votre robots.txt est l’une des étapes techniques ayant le plus fort impact à votre disposition.
Pourquoi Perplexity cite-t-il mon concurrent mais pas moi ?
Les causes les plus fréquentes sont que le contenu de votre concurrent est plus explicitement structuré, plus accessible aux robots d’exploration ou mieux soutenu par des sources tierces. Il se peut également que son contenu réponde aux questions spécifiques des acheteurs que Perplexity récupère, tandis que votre contenu couvre un terrain différent ou utilise un langage plus difficile à extraire. Un audit de visibilité IA peut identifier avec précision les lacunes spécifiques à votre situation.
Perplexity nécessite-t-il une stratégie distincte des autres plateformes de recherche d’IA ?
Les principes sous-jacents — accès d’exploration, clarté du contenu, affirmations explicites, corroboration indépendante et signaux d’entité — s’appliquent à tous les grands environnements de recherche par IA. Cela dit, chaque plateforme exploite son propre robot d’exploration, sa propre logique de récupération et son propre comportement de sélection des sources. Une pratique approfondie de la visibilité IA suit et optimise plusieurs plateformes plutôt que de traiter l’une d’entre elles comme le tableau complet.
Que faire ensuite
Si votre marque est ignorée dans les réponses de Perplexity tandis que des sites tiers et des concurrents apparaissent à votre place, la cause remonte presque certainement à un ou plusieurs des cinq facteurs abordés ici : accès d’exploration, extractabilité du contenu, corroboration indépendante, alignement avec le type de requête ou clarté de l’entité. La première étape consiste à établir un diagnostic précis — identifier lequel de ces facteurs est réellement à l’origine de votre situation avant de vous engager dans des modifications qui pourraient ne pas résoudre le vrai problème.
L’audit initial de visibilité IA de CiteHarbor est conçu pour répondre exactement à cette question. Nous évaluons la présence de citation actuelle de votre marque sur ChatGPT, Perplexity, Gemini, Claude et Google AI Overview, mettons en évidence les questions des acheteurs pour lesquelles vous êtes absent et vous montrons où apparaissent vos concurrents à la place. À partir de là, nous gérons le contenu, la publication, la distribution et le suivi continu — vous offrant une image claire de votre situation et une voie gérée vers l’avenir sans ajouter une autre plateforme à votre flux de travail.
Commencez votre essai gratuit de 2 semaines — aucune carte de crédit requise.