Quel contenu est cité par ChatGPT et les moteurs de recherche IA — et pourquoi le format seul ne suffit pas
Les moteurs de recherche IA citent le contenu qui apporte des preuves originales, une structure claire et des réponses précises qu'ils ne sont pas en mesure de générer par eux-mêmes. Ce guide explique quels types de contenu ont le plus de chances d'être cités et comment auditer votre contenu existant pour optimiser sa visibilité dans la recherche IA.
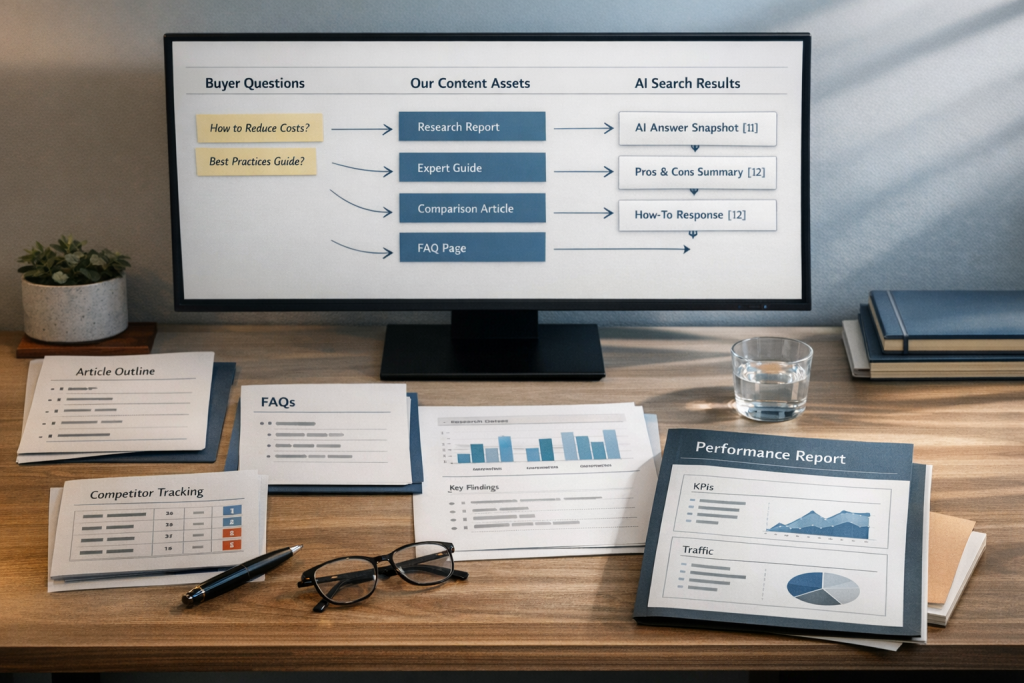
Quel contenu est cité par ChatGPT et les moteurs de recherche IA — Et pourquoi le format seul ne suffit pas
Les moteurs de recherche IA citent le contenu qui renferme quelque chose qu’ils ne peuvent pas générer par eux-mêmes. Les données originales, les preuves de première main, les comparaisons vérifiables et les réponses précises à des questions spécifiques des acheteurs sont ce qui permet d’obtenir des citations — pas un format de blog particulier ou un nombre de mots.
Si vous êtes directeur de contenu, responsable SEO, spécialiste en marketing produit ou chef d’entreprise et que vous vous demandez pourquoi vos articles existants apparaissent rarement dans ChatGPT, Perplexity, Gemini ou Google AI Overviews, la réponse n’est généralement pas que vous avez choisi le mauvais format. La réponse est que votre contenu ne donne pas à ces systèmes une raison de vous attribuer quoi que ce soit en particulier.
Cet article explique quels types de contenu sont le plus souvent cités par les moteurs de recherche IA, pourquoi chaque type obtient des citations, comment les différentes plateformes IA se comportent différemment, et comment évaluer si votre contenu existant est prêt à être cité. Il est rédigé pour les équipes qui investissent déjà dans le contenu ou le SEO et souhaitent comprendre comment fonctionne réellement la visibilité dans les recherches IA.
Le classement et le fait d’être cité ne sont pas la même chose
Avant d’examiner quels types de contenu sont cités, il est important de comprendre pourquoi une page peut bien se classer dans Google tout en restant invisible pour les moteurs de recherche IA. Il s’agit de deux processus de sélection distincts avec des critères différents.
Comment fonctionne le classement dans la recherche traditionnelle
Google classe les pages en fonction de la pertinence, de l’autorité et de l’expérience utilisateur. Une page obtient une position dans les résultats de recherche, et l’utilisateur clique dessus pour la lire. La page elle-même est la destination. Le rôle de Google est de faire remonter les meilleures pages et de laisser l’utilisateur décider laquelle visiter.
Comment la citation par l’IA fonctionne différemment
Lorsque ChatGPT, Perplexity ou Google AI Overviews génèrent une réponse, ils synthétisent des informations provenant de plusieurs sources en une seule réponse. Ils n’envoient pas l’utilisateur vers votre page en premier — ils extraient des informations de votre page et présentent la réponse directement. Si votre page est citée, elle apparaît comme lien source aux côtés de la réponse générée.
Cela signifie que les systèmes IA n’évaluent pas quelle page un utilisateur devrait visiter. Ils évaluent quelle page contient un élément d’information spécifique nécessaire à la construction d’une réponse précise — et quelle source mérite d’en recevoir l’attribution.
Cette distinction change ce que votre contenu doit accomplir. Une page optimisée pour le classement doit être la meilleure ressource globale sur un sujet. Une page optimisée pour la citation doit contenir des affirmations spécifiques, extractibles et attribuables qu’un système IA ne peut pas produire à partir de ses propres données d’entraînement.
Pourquoi une page peut bien se classer et ne toujours pas être citée
De nombreuses pages qui se classent en première page de Google contiennent d’excellents conseils généraux déjà suffisamment connus pour qu’un système d’IA les génère sans avoir besoin de source. Si votre article affirme que la production de contenus de qualité est importante pour le référencement, cette affirmation est vraie — mais un système d’IA n’a pas besoin de citer votre page pour l’énoncer. L’information fait déjà partie de ses données d’entraînement.
Les pages sont citées lorsqu’elles contiennent quelque chose que le système d’IA ne peut pas générer avec certitude à partir de ses propres connaissances : une statistique précise, un cadre propriétaire, une observation de première main, une comparaison structurée qui résout une vraie question, ou une définition précise que le système préfère attribuer plutôt que risquer de se tromper.
La logique sous-jacente de ce que les systèmes d’IA souhaitent citer
Plutôt que de mémoriser une liste de formats de contenu, il est plus utile de comprendre les trois conditions qui rendent tout contenu digne d’être cité. Chaque recommandation de format ci-dessous est liée à ces trois couches.
Couche 1 : Le contenu contient quelque chose que l’IA ne peut pas générer elle-même
C’est le facteur le plus important. Les systèmes d’IA sont entraînés sur de vastes quantités de texte. Ils peuvent générer des explications plausibles sur la plupart des sujets courants sans faire référence à une source spécifique. Ce qu’ils ne peuvent pas générer :
- Des données de recherche originales sur lesquelles ils n’ont pas été entraînés
- Des résultats d’enquêtes propriétaires ou des références comparatives
- Une expérience de première main avec un produit, un processus ou un marché spécifique
- Les tarifs actuels, la disponibilité ou les détails des spécifications
- Des faits vérifiables qui évoluent avec le temps et nécessitent une source fiable
- Une analyse d’expert qui dépend de qualifications ou d’une autorité dans le domaine
Si votre contenu n’apporte aucun de ces éléments, les systèmes d’IA n’ont aucune raison structurelle de vous citer. Ils peuvent dire la même chose sans attribution.
Couche 2 : Le contenu est structurellement facile à extraire
Même lorsqu’une page contient des informations originales et précieuses, les systèmes d’IA peuvent l’ignorer si l’information est enfouie dans de longs paragraphes, enveloppée dans un langage ambigu, ou cachée derrière des éléments de navigation que les robots d’exploration ne peuvent pas analyser.
Le contenu extractible présente des caractéristiques spécifiques : des titres clairs qui indiquent ce que contient chaque section, des paragraphes autonomes qui développent un seul point, des phrases d’ouverture déclaratives et une terminologie cohérente. Ce ne sont pas des astuces — ce sont les mêmes qualités qui rendent le contenu facile à parcourir pour un lecteur pressé.
Couche 3 : Le contenu provient d’une source que le système d’IA peut attribuer avec confiance
Les systèmes d’IA sont de plus en plus prudents quant aux sources. Ils préfèrent les pages sur des domaines disposant d’une autorité thématique établie, les pages auxquelles d’autres sources crédibles ont fait des liens, et les pages comportant des signaux d’auteur clairs. Un article bien structuré sur un tout nouveau domaine, sans backlinks ni historique thématique, a moins de chances d’être cité que le même article sur un domaine ayant démontré son expertise dans ce domaine au fil du temps.
Cela ne signifie pas que les sites plus petits ou plus récents ne peuvent pas être cités — mais cela signifie que la construction d’une valeur de citation est un processus cumulatif, et non une optimisation ponctuelle.
Formats de contenu les plus susceptibles d’être cités
Certains formats de contenu sont cités plus fréquemment parce qu’ils satisfont naturellement les trois niveaux ci-dessus. Voici ce que les tendances observables suggèrent, ainsi que le raisonnement derrière l’avantage de chaque format.
Recherche originale et données propriétaires
La recherche originale est le principal moteur des citations par l’IA. Lorsqu’une page contient une découverte spécifique issue d’une étude propriétaire — un pourcentage, une tendance, une comparaison — les systèmes d’IA citent cette page parce qu’ils ne peuvent pas générer eux-mêmes ce point de données de manière responsable.
Cela comprend les enquêtes sectorielles, les rapports de référence internes, les analyses du comportement des clients, les études de marché, et tout contenu dans lequel l’éditeur a collecté ou analysé des données qui n’existent pas ailleurs. La recherche n’a pas besoin d’être académique. Une entreprise de toiture qui publie ses propres données sur les délais moyens des projets par région, ou une entreprise SaaS qui partage des modèles d’utilisation agrégés, crée le même type d’opportunité de citation.
L’exigence clé est la spécificité. Une page qui n’offre qu’une observation vague sur les entreprises ayant des difficultés avec le ROI du contenu est générique. Une page qui rapporte une découverte concrète issue d’une analyse de programmes réels — avec une taille d’échantillon spécifique et un pourcentage spécifique — donne à un système d’IA quelque chose de concret à citer.
Contenu de comparaison structurée et d’aide à la décision
Les pages de comparaison — lorsqu’elles sont bien réalisées — sont fréquemment citées parce qu’elles aident les systèmes d’IA à répondre à une catégorie de questions qu’ils reçoivent en permanence : ce qui distingue une option d’une autre, ou quel choix convient à une situation particulière.
Les systèmes d’IA peuvent générer des comparaisons génériques à partir des données d’entraînement, mais ils préfèrent citer des pages qui incluent des détails spécifiques, actuels et vérifiables : des comparatifs fonctionnalité par fonctionnalité, des niveaux de tarification, des recommandations par cas d’usage, des limitations et des compromis. Plus la comparaison est spécifique et actuelle, plus elle a de chances d’être citée.
Cela s’applique tout autant aux cabinets d’avocats comparant des stratégies juridiques, aux entreprises de CVC comparant des options d’équipement, aux consultants B2B comparant des méthodologies, et aux entreprises SaaS comparant des catégories de produits.
Contenu au format FAQ et questions-réponses
Les sections FAQ et les articles structurés en questions-réponses sont fréquemment cités car ils correspondent à la façon dont les utilisateurs interrogent les systèmes d’IA. Lorsque quelqu’un demande à ChatGPT combien de temps dure le remplacement d’une toiture commerciale, le système recherche une source qui répond à cette question précise dans un format concis et citable. Une page qui pose cette question sous forme d’en-tête et y répond en deux ou trois phrases claires est structurellement idéale pour la citation.
La distinction essentielle est que la FAQ doit contenir des réponses véritablement utiles et précises — et non du contenu de remplissage. Une réponse FAQ qui renvoie entièrement à des variables situationnelles n’apporte rien. Une réponse FAQ qui indique un délai spécifique et les conditions qui l’influencent offre au système d’IA un bloc citable et référençable.
Articles informatifs complets et guides long format
Les articles approfondis qui traitent un sujet de manière exhaustive — avec une structure de sections claire, plusieurs sous-thèmes et des détails précis à l’appui — ont tendance à être cités car ils constituent des sources de référence fiables. Les systèmes d’IA peuvent extraire différentes sections d’un même article pour répondre à différentes facettes d’une requête complexe.
Ces articles sont plus efficaces lorsqu’ils combinent étendue et précision. Chaque section doit être suffisamment autonome pour être extraite indépendamment, même si l’article complet offre une vision globale du sujet.
Contenu faisant autorité en première partie
Pour les requêtes commerciales et transactionnelles, les systèmes d’IA citent de plus en plus les pages en première partie : documentation produit, descriptions de services, pages de transparence tarifaire, aperçus des capacités et mentions des limitations. Lorsque quelqu’un demande à un système d’IA ce qu’un service inclut ou comment fonctionne une catégorie de produits, le système préfère citer la source qui dispose d’une autorité directe sur la réponse.
Il s’agit d’un type de contenu dans lequel de nombreuses entreprises B2B sous-investissent. La page produit existe, mais elle est rédigée pour la conversion plutôt que pour l’information. Ajouter du contenu informatif clair, précis et bien structuré aux pages en première partie augmente la probabilité que les systèmes d’IA les citent pour des requêtes pertinentes.
Contenu récemment mis à jour sur des sujets en évolution
Les systèmes d’IA dotés de capacités de recherche web — notamment ChatGPT avec la navigation, Perplexity et Google AI Overviews — accordent de l’importance à la récence pour les sujets qui évoluent dans le temps. Un guide sur les délais de déclaration fiscale, la compatibilité des logiciels ou les exigences réglementaires a plus de chances d’être cité s’il a été mis à jour récemment et reflète l’état actuel des choses.
Cela ne signifie pas que tout le contenu doit être récent. Les explications intemporelles de concepts stables ne nécessitent pas de mises à jour constantes. Mais le contenu portant sur des sujets où l’exactitude évolue — tarification, réglementations, technologie, conditions de marché — doit refléter la réalité actuelle pour être digne de citation.
Contenu généré par les utilisateurs et discussions communautaires
Les systèmes d’IA citent également des plateformes communautaires — Reddit, LinkedIn, des forums sectoriels et YouTube — lorsque ces plateformes contiennent des expériences de première main, des recommandations spécifiques ou des avis détaillés qui n’existent pas dans les contenus publiés traditionnels. Cela mérite d’être souligné, car cela signifie qu’une partie de la concurrence en matière de citation pour votre marque provient de contenu généré par les utilisateurs, et pas seulement d’éditeurs concurrents.
Pour les entreprises, l’implication pratique est que participer de manière significative aux communautés pertinentes et veiller à ce que votre contenu propriétaire réponde aux mêmes questions posées dans ces forums peut contribuer à maintenir la visibilité en matière de citation.
Les différents moteurs d’IA citent de manière différente
L’une des erreurs les plus courantes dans la stratégie de visibilité IA est de traiter tous les moteurs de recherche IA comme identiques. Ce n’est pas le cas. Chaque système possède des méthodes de récupération différentes, des préférences de sources différentes et des comportements de citation différents.
| Plateforme IA | Comportement de citation | Tendances des sources |
|---|---|---|
| ChatGPT (with web search) | Cite un nombre modéré de sources par réponse. Tend à mêler synthèse et attribution directe. Insère des citations en ligne lors de l’énoncé de déclarations factuelles spécifiques. | Puise dans un vaste corpus web. Peut citer des sources qui n’apparaissent pas dans les premiers résultats Google. Privilégie les pages comportant des déclarations claires et explicites ainsi que des preuves spécifiques. |
| Perplexity | Conçu pour multiplier les citations. Fournit des citations en ligne numérotées pour la plupart des affirmations. Affiche les fiches sources de manière bien visible aux côtés de la réponse. | Récupère activement les résultats depuis la recherche web en direct. Tend à favoriser les pages dotées d’une forte autorité thématique et d’affirmations spécifiques et vérifiables. Cite fréquemment Reddit et les sources communautaires pour les requêtes expérientielles. |
| Google AI Overviews | Cite un petit nombre de sources (généralement 3 à 6) affichées sous forme de cartes extensibles en dessous ou à côté de l’aperçu généré. | Tend à puiser dans les pages bien classées dans l’index organique de Google. Privilégie le contenu structuré, l’autorité de domaine reconnue et la pertinence thématique claire. |
| Google Gemini | Le format de citation varie selon le type de requête. Fournit parfois des liens vers les sources, parfois non. Moins systématiquement chargé en citations que Perplexity. | S’appuie fortement sur l’index de Google. Tend vers des réponses plus courtes et plus condensées. Peut favoriser les pages concises à haute densité d’information. |
Ce que cela signifie pour une stratégie de contenu est simple : un seul article peut mériter d’être cité sur plusieurs plateformes, mais uniquement s’il satisfait le dénominateur commun — des preuves originales, une structure claire, des réponses spécifiques et une accessibilité explorable. Optimiser pour un seul moteur IA au détriment des autres est rarement la bonne approche.
Signaux structurels et techniques qui augmentent la probabilité de citation
Au-delà du format et du fond, la façon dont le contenu est physiquement structuré sur la page détermine si les systèmes d’IA peuvent le trouver, l’analyser et l’extraire.
Mise en forme pour l’extractabilité
- Titres descriptifs : Utilisez des titres H2 et H3 qui indiquent clairement ce que couvre chaque section. Un titre comme « Combien de temps prend le remplacement d’un toit commercial ? » donne aux systèmes d’IA un signal immédiat sur le contenu qui suit — une étiquette vague comme « Considérations de calendrier » ne le fait pas.
- Paragraphes autonomes : Rédigez des paragraphes dont la première phrase énonce le point principal. Les systèmes d’IA extraient souvent un seul paragraphe — si l’information clé se trouve dans la troisième phrase, elle risque d’être ignorée.
- Listes à puces et numérotées : Utilisez des listes pour les groupes d’éléments connexes, les étapes ou les critères. Les listes sont structurellement faciles à analyser et à reproduire avec attribution pour les systèmes d’IA.
- Tableaux : Utilisez des tableaux de comparaison pour présenter les différences de fonctionnalités, les détails des options ou les comparaisons de catégories. Les tableaux sont très facilement extractibles et réduisent l’ambiguïté.
Phrases déclaratives et terminologie cohérente
Les systèmes d’IA sont plus susceptibles de citer des phrases qui formulent une affirmation claire et directe. Une phrase qui indique un délai précis pour un cycle de vente de logiciels d’entreprise est plus facilement citable qu’une phrase qui reconnaît que le cycle varie selon la situation. L’une donne au système quelque chose à attribuer ; l’autre ne lui offre rien sur quoi s’appuyer.
La cohérence est également importante. Si vous utilisez « citation IA » dans une section, « mention IA » dans une autre et « référence IA » dans une troisième, vous introduisez une ambiguïté quant à savoir si vous désignez le même concept. Utilisez le même terme tout au long du contenu.
Le balisage Schema comme aide à l’analyse
Le balisage Schema — en particulier le schéma Article pour le contenu de blog et le schéma FAQPage pour les sections FAQ — aide les moteurs de recherche et les systèmes d’IA à comprendre ce que contient une page et comment elle est structurée. Le balisage Schema ne garantit pas les citations, mais il réduit les frictions dans le processus d’analyse.
N’appliquez que le balisage Schema qui représente fidèlement le contenu de la page. Ajouter le schéma FAQPage à une page sans véritable section FAQ est trompeur et peut poser des problèmes avec les moteurs de recherche.
Autoriser les robots d’exploration IA à accéder à votre contenu
Si votre fichier robots.txt bloque les robots d’exploration IA, votre contenu ne peut pas être cité par les systèmes que ces robots servent. Il s’agit d’une erreur technique courante. Plus précisément :
- Autorisez OAI-SearchBot si vous souhaitez être éligible aux résultats de recherche ChatGPT. OpenAI a déclaré que les sites bloquant ce robot d’exploration n’apparaîtront pas dans les réponses de recherche ChatGPT.
- Assurez-vous que l’accès de Googlebot n’est pas restreint par inadvertance, ce qui affecte les Google AI Overviews.
- Confirmez que votre contenu principal est rendu en HTML explorable, et non chargé entièrement via JavaScript que les robots d’exploration ne peuvent pas exécuter.
Ce que les systèmes d’IA dépriorisent systématiquement
Comprendre ce qui n’est pas cité est aussi utile que comprendre ce qui l’est. Les systèmes d’IA ont tendance à ignorer le contenu présentant ces caractéristiques — non pas en raison d’une pénalité, mais parce que ce contenu ne répond pas à leurs besoins de sélection.
- Le contenu qui ne fait que reformuler des connaissances communes : Si l’article ne dit rien qu’un système d’IA ne pourrait pas générer à partir de ses données d’entraînement, il n’y a aucune raison de le citer.
- Le contenu comportant des affirmations vagues et non étayées : Les affirmations telles que prétendre être le meilleur du secteur ou laisser les résultats parler d’eux-mêmes ne sont pas utiles à un système d’IA qui élabore une réponse factuelle.
- Le contenu enfoui derrière des formats inaccessibles : Les informations contenues dans des PDF, des images, des vidéos intégrées ou des éléments rendus par JavaScript que les robots d’exploration ne peuvent pas traiter.
- Les pages légères qui abordent un sujet de manière superficielle : Un article de blog de 200 mots qui effleure à peine son sujet fournit moins de matière d’extraction utile qu’un article complet et bien organisé.
- Le contenu dupliqué ou quasi-dupliqué : Si le même article existe en plusieurs versions sur un site, les systèmes d’IA peuvent ne citer aucune d’entre elles, car le signal de source n’est pas clair.
- Les pages bloquées par robots.txt ou marquées comme noindex : Il s’agit d’un problème d’éligibilité technique, et non d’un problème de qualité de contenu, mais tout aussi efficace pour empêcher les citations.
Comment auditer votre contenu existant pour son aptitude à la citation
Si vous disposez d’une bibliothèque de contenu peu performante dans les recherches IA, le cadre suivant peut vous aider à évaluer ce qui mérite d’être mis à jour, ce qui nécessite une restructuration et ce qui manque entièrement.
Couche 1 — Découvrabilité : les systèmes d’IA peuvent-ils trouver cette page ?
Posez-vous ces questions pour chaque page :
- La page est-elle indexée par Google ?
- La page est-elle accessible aux robots d’exploration de l’IA (non bloquée dans robots.txt) ?
- Le contenu principal est-il en HTML explorable ?
- La page possède-t-elle une URL claire et descriptive ?
- La page est-elle liée à d’autres pages du site et à des sources externes ?
Si l’une de ces réponses est négative, la page n’est pas éligible à la citation, quelle que soit la qualité de son contenu.
Couche 2 — Extractibilité : les systèmes d’IA peuvent-ils identifier rapidement ce que dit cette page ?
- La page possède-t-elle un titre clair qui décrit le sujet ?
- Les titres résument-ils fidèlement le contenu de chaque section ?
- Le premier paragraphe énonce-t-il la réponse centrale ou la thèse ?
- Les affirmations clés sont-elles formulées dans des phrases directes et déclaratives ?
- Les définitions, comparaisons ou données sont-elles présentées dans des formats extractibles (paragraphes courts, listes, tableaux) ?
- Le balisage de schéma est-il appliqué avec précision ?
Une page peut être découvrable mais non extractible si ses informations sont dispersées, ambiguës ou enfouies dans une prose narrative dépourvue de clarté structurelle.
Couche 3 — Valeur de citation : cette page contient-elle quelque chose qui mérite d’être cité ?
- La page contient-elle des données originales, des recherches ou des preuves de première main ?
- La page répond-elle à une question précise que les acheteurs posent réellement ?
- La page propose-t-elle une comparaison, un cadre d’analyse ou un outil d’aide à la décision spécifique ?
- La page fournit-elle des informations que les systèmes d’IA ne peuvent pas générer à partir de leurs données d’entraînement générales ?
- La suppression de cette page d’Internet rendrait-elle une réponse précise moins exacte ?
Cette dernière question est le diagnostic le plus utile. Si la réponse est non — si le système d’IA produirait la même réponse sans votre page — alors votre contenu n’est pas encore digne de citation sur ce sujet.
Pourquoi cela est important pour les équipes qui investissent déjà dans le contenu
De nombreuses entreprises avec lesquelles nous échangeons chez CiteHarbor produisent déjà du contenu de blog, mènent déjà des programmes SEO et investissent déjà dans le marketing de contenu. La frustration ne vient pas d’un manque de contenu — elle vient du fait que leur contenu ne fonctionne pas dans la recherche IA.
Le schéma est généralement le même. Le contenu a été créé pour le SEO traditionnel : cibler un mot-clé, rédiger un article complet, optimiser le titre et la méta-description, obtenir des liens et publier. Cette approche peut encore générer du trafic de recherche organique. Mais elle ne produit pas automatiquement du contenu que les systèmes d’IA citent.
Le manque se situe presque toujours dans la couche de recherche sur les questions des acheteurs. Le contenu cible des mots-clés plutôt que des questions. Il traite les sujets de manière générique plutôt que de répondre à des requêtes précises avec des preuves spécifiques. Il se lit bien comme ressource générale, mais ne contient pas de blocs discrets et citables qu’un système d’IA attribuerait à la source.
C’est la différence fondamentale entre le marketing de contenu traditionnel et une stratégie de contenu conçue pour la visibilité IA. Il ne s’agit pas de choisir des formats différents. Il s’agit de partir de questions différentes — les questions précises que vos acheteurs posent aux assistants IA — et de créer du contenu qui donne aux systèmes d’IA quelque chose qui mérite d’être cité.
Comment CiteHarbor aborde cette question
CiteHarbor existe parce que la plupart des entreprises n’ont pas le temps ni les ressources internes pour rechercher les questions des acheteurs sur les plateformes IA, créer du contenu conçu pour la valeur de citation, publier et distribuer ce contenu de manière cohérente, suivre si les systèmes d’IA les citent réellement, et surveiller pour quoi les concurrents sont cités.
Notre approche couvre l’ensemble du flux de travail :
- Audit de visibilité IA : Nous établissons une référence de l’endroit où votre marque apparaît actuellement — et là où elle est absente — sur ChatGPT, Perplexity, Gemini, Claude et Google AI Overviews.
- Recherche sur les questions des acheteurs : Nous identifions les questions précises que vos acheteurs posent aux assistants IA, et pas seulement les mots-clés qu’ils recherchent sur Google.
- Création de contenu : Nous produisons des articles conçus autour de ces questions d’acheteurs, structurés pour être à la fois utiles aux humains et extractibles par les IA.
- Publication et distribution : Nous gérons la publication WordPress et la distribution sur les réseaux sociaux afin que vous n’ayez pas à gérer un workflow supplémentaire.
- Suivi des citations et veille concurrentielle : Nous surveillons les tendances de citation des IA chaque mois, suivons la visibilité de vos concurrents et vous envoyons un rapport de performance PDF à votre image.
Vous ne gérez pas de tableau de bord. Vous ne vous connectez pas à une autre plateforme. Vous recevez un rapport mensuel clair indiquant où vous en êtes et ce qui a évolué.
Il ne s’agit pas d’un produit logiciel. C’est un service à service complet qui élimine la charge opérationnelle liée à la visibilité IA — la recherche, le contenu, la publication, le suivi et le reporting.
Foire aux questions
Quelle est la différence entre se classer sur Google et être cité par ChatGPT ?
Le classement Google détermine quelles pages apparaissent dans les résultats de recherche pour qu’un utilisateur puisse les consulter. La citation par une IA détermine quelles pages sont référencées comme sources lorsqu’un système d’IA génère une réponse. Une page peut être bien classée sans être citée, et dans certains cas, une page peut être citée par des systèmes d’IA même si elle ne détient pas un classement Google de premier rang pour la même requête.
Quel format de contenu est le plus souvent cité par les moteurs de recherche IA ?
Les tendances observables suggèrent que les recherches originales comportant des données spécifiques sont citées le plus fréquemment, suivies des comparaisons structurées, des contenus au format FAQ et des articles informatifs complets. Cependant, le format seul n’est pas le facteur déterminant — la valeur d’une citation dépend du fait que le contenu contient quelque chose que le système d’IA ne peut pas générer de façon autonome.
ChatGPT, Perplexity et Google AI Overviews citent-ils les mêmes sources ?
Pas toujours. Chaque plateforme dispose de méthodes de récupération différentes et de préférences de sources différentes. Google AI Overviews s’appuie principalement sur des pages qui obtiennent de bons résultats dans le propre index de Google. Perplexity explore le web en direct de façon étendue et cite fréquemment des contenus communautaires. ChatGPT peut s’appuyer sur des sources qui n’apparaissent pas dans les premiers résultats Google. Une stratégie de contenu multi-moteurs devrait viser le dénominateur commun : des preuves originales, une structure claire et une accessibilité d’exploration.
Le balisage schema aide-t-il pour les citations IA ?
Le balisage schema aide les moteurs de recherche et les systèmes d’IA à analyser votre contenu plus précisément. Les schemas Article et FAQPage sont les types les plus pertinents pour les contenus de blog. Le schema ne garantit pas les citations, mais il supprime un obstacle technique qui pourrait empêcher les systèmes d’IA de comprendre correctement votre page.
Les sites web de petite taille ou récents peuvent-ils être cités par les moteurs IA ?
Oui, mais c’est plus difficile sans autorité thématique établie. Les sites plus récents peuvent améliorer leurs chances en se concentrant sur des questions d’acheteurs très spécifiques où la concurrence est moindre, en produisant des recherches originales ou des données de première main que les concurrents plus importants n’ont pas publiées, et en développant progressivement une profondeur thématique plutôt qu’en essayant de couvrir tous les sujets.
Comment savoir si mon contenu est actuellement cité par des systèmes d’IA ?
Vous pouvez effectuer des tests manuels en posant aux assistants IA les mêmes questions que vos acheteurs posent, puis en vérifiant si votre marque ou vos pages apparaissent dans la réponse. Pour un suivi systématique et continu, un processus de surveillance est nécessaire pour vérifier régulièrement les tendances de citation sur plusieurs plateformes d’IA. C’est l’une des fonctions principales que CiteHarbor assure dans le cadre de son service géré.
À quelle fréquence dois-je mettre à jour mon contenu pour maintenir la probabilité de citation ?
Les explications pérennes de concepts stables ne nécessitent pas de mises à jour fréquentes. Le contenu traitant de sujets qui évoluent — tarification, réglementations, technologie, conditions du marché — doit être mis à jour dès que les faits essentiels changent. Une révision trimestrielle de vos articles les plus importants constitue un point de départ raisonnable pour la plupart des entreprises.
Pour aller plus loin
Si votre stratégie de contenu actuelle produit des articles qui suscitent peu d’engagement et n’apparaissent pas lorsque vos acheteurs interrogent des assistants IA sur votre catégorie, le problème n’est presque certainement pas lié à l’effort ou au volume. C’est que le contenu a été conçu pour un système différent — la recherche traditionnelle — et n’a pas été adapté à un monde où les moteurs d’IA synthétisent des réponses à partir de sources qu’ils jugent dignes d’être citées.
La bonne nouvelle est que l’amélioration de la visibilité IA ne signifie pas repartir de zéro. Cela commence par la compréhension de votre niveau de référence actuel, l’identification des questions d’acheteurs les plus importantes et la création de contenu qui donne aux systèmes d’IA une raison légitime de vous citer.
CiteHarbor gère tout cela — l’audit, la recherche, le contenu, la publication, le suivi et le reporting — afin que vous obteniez la visibilité sans la charge de gestion.
Commencez votre essai gratuit de 2 semaines — aucune carte de crédit requise.