¿Qué fuentes utiliza Perplexity para recomendar empresas o software?
Descubre cómo Perplexity selecciona las fuentes cuando recomienda empresas o software: desde páginas web y plataformas de reseñas hasta foros, documentación oficial y socios de datos premium. Este artículo explica cómo el tipo de consulta y los modos de enfoque determinan qué se cita.
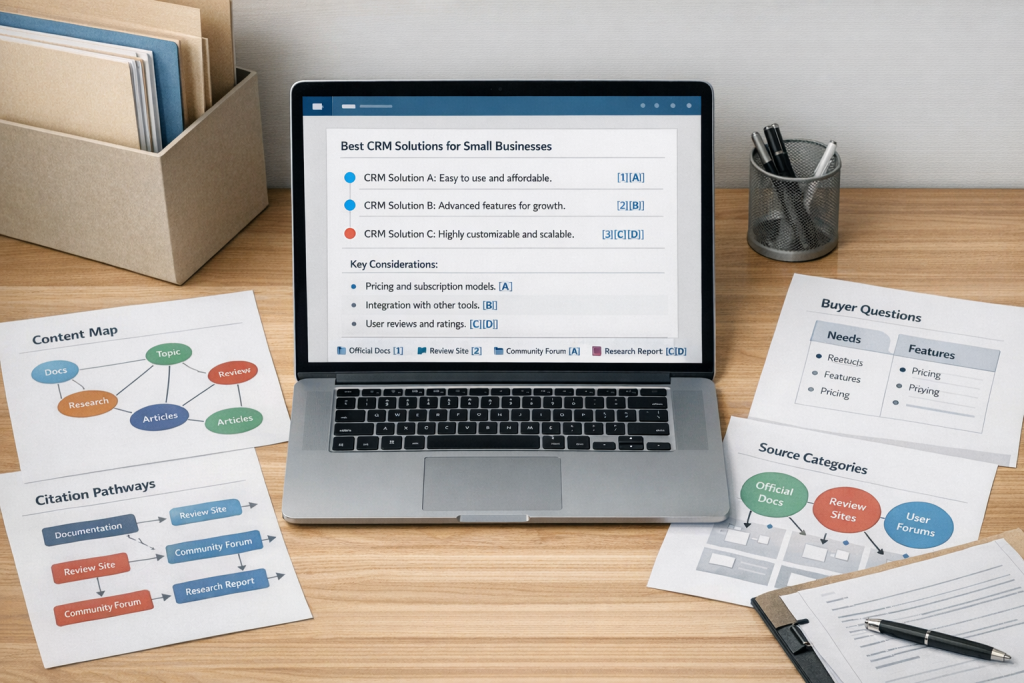
¿Qué fuentes usa Perplexity al recomendar empresas o software?
Perplexity no mantiene un directorio fijo de empresas o productos de software aprobados. Cada consulta activa un proceso de recuperación en tiempo real que ensambla respuestas a partir de una combinación cambiante de contenido web, plataformas de reseñas, documentación oficial, debates de la comunidad y —para los suscriptores Pro y Enterprise— socios de datos premium con licencia. Las fuentes que aparecen en cada respuesta dependen de la naturaleza de la pregunta, de la especificidad de la consulta y de lo que el sistema de recuperación considera más relevante en ese momento.
Este artículo analiza cada categoría de fuentes de la que extrae Perplexity, explica cómo el tipo de consulta modifica la combinación de fuentes, describe los modos de enfoque que permiten al usuario orientar el conjunto de fuentes y aborda lo que todo esto significa para las empresas y los proveedores de software que intentan comprender su visibilidad dentro de las respuestas generadas por IA.
Cómo recupera Perplexity las fuentes para cada consulta
Perplexity funciona como un motor de respuestas más que como un motor de búsqueda tradicional. El usuario envía una pregunta y recibe una respuesta sintetizada con citas en línea —no una lista clasificada de enlaces para explorar—. El sistema recupera contenido de toda la web en tiempo real, utiliza ese contenido para construir una respuesta directa y vincula cada afirmación con la fuente de la que procede para que el lector pueda verificar la información.
El enfoque técnico detrás de esto es la generación aumentada por recuperación, conocida habitualmente por sus siglas en inglés RAG. Su significado práctico: el modelo de lenguaje subyacente no depende únicamente de lo que aprendió durante el entrenamiento. Para cada consulta, busca en la web, extrae contenido de las páginas que considera más relevantes y utiliza ese material recuperado para dar forma a la respuesta. La respuesta se genera de nuevo para cada consulta, y las fuentes citadas pueden variar según lo que se haya publicado recientemente, lo que sea accesible en ese momento y en qué medida una página determinada coincide con la pregunta formulada.
Por eso dos personas que formulan versiones ligeramente distintas de la misma pregunta pueden recibir respuestas que citan fuentes completamente diferentes. La recuperación es en tiempo real y específica para cada consulta, no se extrae de una caché fija.
Punto clave: Las citas en línea en las respuestas de Perplexity no son decorativas. Son la forma que tiene el sistema de mostrar qué páginas recuperó, evaluó y utilizó como base para partes específicas de su respuesta. Cada enlace citado representa una página que superó el umbral de relevancia del sistema de recuperación para esa consulta concreta.
Las principales categorías de fuentes de las que extrae Perplexity
Perplexity no trabaja a partir de una única lista de fuentes aprobadas. Extrae de varias categorías de contenido diferenciadas, y qué categorías predominan en cada respuesta depende de la consulta. Comprender estas categorías es fundamental para entender por qué algunas páginas aparecen en las recomendaciones de IA y otras no.
General Web Content and High-Authority Publications
La mayoría de las consultas comienzan en la web abierta. Esto incluye medios de noticias, publicaciones del sector, recopilaciones de producción editorial, guías extensas con autoridad y dominios bien consolidados. El sistema de recuperación parece favorecer las páginas con contenido sustancial y rico en información frente a las páginas principalmente promocionales o con estructura escasa.
Los patrones observados sugieren que las páginas con una organización clara, afirmaciones factuales específicas y autoridad temática demostrada se recuperan y citan de forma más consistente. Las páginas basadas en un lenguaje de ventas agresivo, contenido original mínimo o relleno de palabras clave tienden a ser filtradas o ignoradas en favor de alternativas más sustanciales.
Plataformas de reseñas y comparativas de software
Cuando una consulta pide a Perplexity que recomiende software —ya sean herramientas de gestión de proyectos, plataformas CRM, software de contabilidad o cualquier otra categoría—, el sistema recurre con frecuencia a plataformas dedicadas a reseñas y comparativas. G2, Capterra y TrustRadius se encuentran entre las fuentes más observadas en esta categoría.
Estas plataformas aparecen porque consolidan reseñas estructuradas de usuarios, comparativas función por función, datos de precios y clasificaciones por categoría en un solo lugar. Para un sistema de recuperación que elabora una recomendación de software, ese tipo de contenido organizado y comparativo resulta directamente útil.
Lo que se cita de estas plataformas no suele ser la página de inicio. Perplexity extrae con regularidad de páginas de categorías específicas, perfiles individuales de productos, páginas de comparativas directas y resúmenes de reseñas —la página que más se ajuste a los detalles de lo que se preguntó.
Fuentes oficiales de fabricantes y empresas
Perplexity cita con frecuencia páginas oficiales de empresas cuando una consulta se refiere a un producto o negocio específico. Las páginas de productos, páginas de precios, centros de documentación, centros de ayuda, páginas «sobre nosotros» y notas de prensa pertenecen todas a esta categoría.
Estas páginas tienden a aparecer con más frecuencia cuando la consulta es concreta y específica de un producto —preguntando qué ofrece una empresa determinada o cómo funciona una función específica—, en lugar de cuando la consulta es una comparativa de categoría amplia. Para preguntas abiertas como «mejor CRM para pequeñas empresas», Perplexity tiende a apoyarse en fuentes de terceros. Para preguntas concretas sobre productos, es más probable que acceda directamente al contenido propio del proveedor.
La implicación práctica: si la documentación oficial de productos de una empresa está desactualizada, mal organizada o estructurada de formas que dificultan el procesamiento por parte de los rastreadores, Perplexity puede citar una versión anterior de ese contenido, recurrir a una descripción de terceros o ignorar la empresa por completo.
Debates comunitarios y foros
Los hilos de Reddit, las respuestas de Quora, los foros de desarrolladores y las comunidades de nicho del sector aparecen con regularidad en las citas de Perplexity, en especial para consultas con una dimensión de sentimiento o experiencia. Preguntas como «¿qué piensan los usuarios reales de este producto?», «¿realmente vale la pena pagar por esta herramienta?» o «el mejor proveedor de servicios en esta ciudad» sacan a la superficie con frecuencia debates de comunidades como fuentes primarias o de apoyo.
El sistema parece favorecer el contenido de comunidades cuando la naturaleza de la consulta indica que el usuario busca una experiencia de usuario auténtica en lugar de afirmaciones producidas por el proveedor. Las marcas con una presencia genuina en las comunidades relevantes —a través de conversaciones orgánicas de usuarios, no de publicaciones fabricadas— le ofrecen a Perplexity más material del que extraer cuando llegan esas consultas orientadas a la experiencia.
Lo contrario también se cumple. Una marca sin presencia significativa en los debates de comunidades puede encontrarse con que Perplexity simplemente tiene menos con qué trabajar cuando los usuarios formulan preguntas orientadas a la experiencia sobre esa categoría.
Socios de datos con licencia premium
Los suscriptores de Perplexity Pro y Enterprise reciben respuestas que pueden recurrir a fuentes de datos con licencia premium no disponibles en la web abierta. Son bases de datos de nivel profesional con las que Perplexity ha establecido alianzas para profundizar en la calidad de sus respuestas para consultas de negocios, finanzas e investigación de mercado.
Los socios premium confirmados y lo que cada uno aporta al conjunto de fuentes:
- PitchBook: Inteligencia del mercado privado que abarca firmografía, rondas de financiación, perfiles de inversores y actividad de operaciones. Más relevante para consultas sobre startups, empresas respaldadas por capital de riesgo y dinámicas del mercado privado.
- CB Insights: Seguimiento de startups, mapeo de mercados, análisis del panorama competitivo y datos de tendencias del sector. Más relevante para consultas de estrategia empresarial e investigación de mercado.
- Statista: Estadísticas globales, cifras de dimensionamiento del mercado, previsiones del sector y datos de investigación del consumidor. Más relevante para consultas que requieren información cuantificada del mercado.
- IBISWorld: Informes de investigación del sector y análisis de las condiciones del mercado. Más relevante para consultas sobre verticales del sector específicas y dinámicas a nivel sectorial.
- Dun & Bradstreet: Datos de crédito empresarial, perfiles de empresas, registros firmográficos B2B y evaluación del riesgo comercial. Más relevante para consultas sobre credibilidad empresarial, evaluación de proveedores e investigación de antecedentes de empresas.
- Guidepoint: Acceso a redes de expertos e investigación primaria. Más relevante para consultas especializadas que se benefician de una perspectiva de nivel profesional.
- Wiley: Revistas académicas y profesionales, material de referencia de negocios y STEM. Más relevante para consultas que requieren fuentes revisadas por pares o de carácter académico.
Estas fuentes premium aparecen con mayor frecuencia en consultas empresariales B2B, solicitudes de inteligencia competitiva, preguntas sobre dimensionamiento del mercado e investigación financiera. Un usuario estándar de nivel gratuito no verá respuestas informadas por estas bases de datos, lo que significa que la combinación de fuentes para la misma pregunta puede diferir sustancialmente según el nivel de suscripción del usuario.
Cómo el tipo de consulta cambia la combinación de fuentes
Uno de los aspectos más relevantes y menos debatidos del comportamiento de fuentes de Perplexity es que la combinación de fuentes cambia notablemente según el tipo de pregunta que se formula. Una consulta sobre un negocio local, una consulta de comparación de software y una consulta de investigación empresarial B2B tienden a recurrir a diferentes categorías de fuentes en diferentes proporciones.
Consultas sobre negocios locales
Cuando alguien pregunta a Perplexity por la mejor empresa de climatización en una ciudad concreta o la representación legal mejor valorada en su zona, el sistema tiende a recurrir a plataformas de reseñas locales, datos de Google Business Profile, Yelp, directorios específicos del sector y debates comunitarios. El sitio web propio de la empresa puede aparecer, pero la respuesta suele estar anclada en señales de credibilidad de terceros: puntuaciones, reseñas y presencia en directorios locales.
Consultas de comparación de software
Una consulta que solicita el mejor software de gestión de proyectos para un equipo de un tamaño concreto desplaza la combinación de fuentes hacia plataformas de reseñas de software como G2, Capterra y TrustRadius, junto con recopilaciones editoriales de publicaciones tecnológicas y documentación oficial de los proveedores. Los debates comunitarios de Reddit o foros de desarrolladores también pueden aparecer, especialmente cuando la consulta incluye una preferencia o restricción que las plataformas de reseñas no abordan directamente.
Consultas de investigación empresarial B2B
Una consulta sobre los principales proveedores de ciberseguridad para empresas de servicios financieros de mercado medio tiende a recurrir a informes de analistas del sector, socios de datos premium para suscriptores Pro, publicaciones empresariales y contenido editorial de referencia. Las plataformas de reseñas pueden seguir apareciendo, pero la combinación de fuentes se inclina hacia contenido más especializado y profundo. Este es el tipo de consulta en el que es más probable que los socios de datos premium como PitchBook, CB Insights e IBISWorld formen parte de la respuesta.
La conclusión práctica: Una empresa que quiera entender su visibilidad en Perplexity debe pensar detenidamente qué tipo de consulta realizaría realmente un comprador potencial y, a continuación, evaluar si la marca cuenta con contenido relevante y accesible en las categorías de fuentes de las que Perplexity se nutre para ese tipo de consulta específico.
Modos de enfoque y cómo controlan la selección de fuentes
Perplexity ofrece a los usuarios la posibilidad de acotar el conjunto de fuentes para cualquier consulta mediante los modos de enfoque. Seleccionar un modo de enfoque cambia qué categorías de contenido prioriza el sistema de recuperación al componer una respuesta.
Los modos de enfoque disponibles incluyen:
- Web: La configuración predeterminada. Recupera información de todo el rango de fuentes web de acceso público.
- Académico: Prioriza la investigación revisada por pares, las revistas académicas y las bases de datos académicas.
- Social: Prioriza las plataformas de redes sociales y el contenido social disponible públicamente.
- Reddit: Limita la recuperación específicamente a los hilos de Reddit y las discusiones de la comunidad.
- YouTube: Prioriza el contenido de vídeo alojado en YouTube.
- Escritura: Orienta el modelo hacia la generación de texto en lugar de la recuperación de fuentes y la cita.
Los modos de enfoque son importantes porque le dan al usuario control directo sobre qué tipo de fuente determina la respuesta. Alguien que busque en el modo Reddit el mejor software de contabilidad para autónomos recibirá una respuesta basada íntegramente en discusiones de Reddit. Eso significa que los productos mencionados serán aquellos que aparezcan de forma orgánica en las conversaciones de Reddit, no necesariamente los que tengan los perfiles más sólidos en plataformas de reseñas o las páginas de marketing más elaboradas.
Perplexity también ofrece un modo Deep Research que amplía el alcance de la recuperación. Deep Research ejecuta un proceso de búsqueda más exhaustivo, extrayendo información de una gama más amplia de fuentes y produciendo respuestas más largas y detalladas. Para consultas de recomendaciones de negocios y software, el modo Deep Research tiende a mostrar un rango más amplio de fuentes, incluidos socios de datos premium, contenido académico y publicaciones sectoriales de nicho que podrían no aparecer en una consulta estándar.
Qué hace que una fuente tenga más probabilidades de aparecer en las respuestas de Perplexity
Nadie fuera de Perplexity tiene visibilidad sobre cómo exactamente su sistema de recuperación puntúa y selecciona las fuentes. Pero los patrones consistentes observados en un gran número de consultas apuntan a características que las páginas citadas con frecuencia tienden a compartir.
- Relevancia directa con la consulta: Las páginas que responden a la pregunta específica planteada, en lugar de a un tema vagamente relacionado, se citan con más consistencia. La precisión supera a la amplitud.
- Actualidad: Para los temas en los que la información cambia con regularidad, como las funciones de software, los precios o los detalles de la empresa, las páginas actualizadas más recientemente parecen ser preferidas sobre el contenido más antiguo.
- Accesibilidad al rastreador: Perplexity opera su propio rastreador web. Una página que bloquea ese rastreador o que no se renderiza en HTML accesible no puede recuperarse ni citarse, independientemente de la calidad del contenido.
- Densidad de información: Las páginas con contenido detallado y rico en datos se citan con más frecuencia que las páginas con contenido escaso, texto genérico o lenguaje que se percibe principalmente como promocional.
- Señales de autoridad temática: La autoridad de dominio, la credibilidad editorial y la experiencia demostrada en el tema específico parecen influir en la selección de fuentes — aunque la autoridad aquí significa credibilidad en el tema concreto, no simplemente la fortaleza general del dominio.
- Corroboración entre fuentes: Cuando una afirmación aparece de forma consistente en múltiples fuentes, Perplexity parece más propenso a incluirla en su respuesta y citar las páginas que la respaldan.
Estos son patrones derivados de la observación, no reglas internas confirmadas. La lógica de recuperación de Perplexity es propietaria. Pero los patrones son lo suficientemente consistentes en consultas repetidas como para servir de marco de trabajo práctico.
Una distinción importante: Ser rastreado por el rastreador de Perplexity no es lo mismo que ser citado en una respuesta de Perplexity. Una página puede existir en el índice sin aparecer nunca como fuente citada. Que una página sea citada requiere que sea recuperable y evaluada como una de las opciones más relevantes y con mayor credibilidad para una consulta específica en el momento en que se realiza.
Qué significa esto para empresas y proveedores de software
Si Perplexity obtiene información de plataformas de reseñas, debates comunitarios, documentación oficial, publicaciones editoriales y socios de datos premium — y la mezcla varía según el tipo de consulta — entonces una empresa que quiera entender su visibilidad en búsquedas de IA necesita considerar todas esas superficies, no solo su propio sitio web.
Así es como se ve en la práctica:
- La presencia en plataformas de reseñas forma parte de la ecuación de visibilidad. Cuando los compradores de software piden recomendaciones a Perplexity y el sistema obtiene información de G2 y Capterra, un perfil actualizado y bien mantenido en esas plataformas afecta directamente si una marca aparece en la respuesta.
- La presencia en comunidades determina con qué material cuenta Perplexity para trabajar. Cuando Perplexity muestra hilos de Reddit y debates en foros para consultas orientadas a la experiencia, las marcas con presencia genuina en comunidades ofrecen al sistema más material de fuentes del que nutrirse en su nombre.
- La documentación oficial debe ser accesible y estar actualizada. Si las páginas de producto, el centro de ayuda o la página de precios de una empresa están desactualizados, bloqueados para los rastreadores, u organizados de maneras difíciles de interpretar, Perplexity puede omitirlos en favor de descripciones de terceros del mismo producto.
- El contenido creado en torno a preguntas reales de compradores se comporta de manera diferente al contenido genérico de blog. Una página que responde directamente a una pregunta específica que un comprador haría — con estructura clara, afirmaciones específicas y evidencia de respaldo — está mejor posicionada para coincidir con la lógica de recuperación que un artículo de concienciación amplio escrito para llenar un calendario editorial.
- La cobertura de datos premium importa para las marcas orientadas al mercado empresarial. Cuando los usuarios de Perplexity Pro reciben respuestas basadas en PitchBook, CB Insights o Dun & Bradstreet, las empresas orientadas al sector corporativo deben entender si tienen presencia en esas bases de datos.
Nada de esto es una garantía. Ninguna empresa puede obligar a Perplexity a citar una página específica ni incluir una marca concreta en una recomendación. Pero entender de qué categorías de fuentes se nutre el sistema —y evaluar si una marca tiene contenido relevante, accesible y creíble en esas categorías— es la base de cualquier estrategia práctica de visibilidad en IA.
Este es el trabajo que CiteHarbor realiza para sus clientes. Auditamos dónde aparece actualmente una marca —y dónde está ausente— en entornos de búsqueda con IA, incluyendo Perplexity, ChatGPT, Gemini, Claude y Google AI Overview. Investigamos las preguntas de los compradores que impulsan las recomendaciones en la categoría del cliente. Producimos contenido diseñado para responder esas preguntas con la estructura, especificidad y profundidad que los sistemas de recuperación de IA tienden a mostrar. Y gestionamos la ejecución completa —publicación en WordPress, distribución en canales sociales, seguimiento de citas mensual, monitorización de la visibilidad de los competidores y entrega de instantáneas de rendimiento de marca— para que el cliente no tenga que gestionar otra plataforma ni otro flujo de trabajo.
El objetivo no es manipular ningún motor de IA. El objetivo es garantizar que la marca tenga contenido útil, fácil de encontrar y bien estructurado en los lugares donde los sistemas de IA ya están buscando.
Preguntas frecuentes
¿Utiliza Perplexity Google o Bing para encontrar fuentes?
Sí. Perplexity utiliza múltiples APIs de búsqueda, incluyendo Google y Bing, junto con su propio rastreador web propietario. Los resultados de estas entradas se combinan para construir el grupo de fuentes de cada consulta. El sistema no está limitado al índice de ningún motor de búsqueda en concreto.
¿Utiliza Perplexity fuentes fiables?
Perplexity aplica una lógica de filtrado que parece favorecer el contenido denso en información, objetivo y con autoridad frente a las páginas escasas o muy promocionales. El sistema de citas en línea añade una capa de transparencia: cada fuente citada está enlazada directamente en la respuesta para que el lector pueda evaluarla de forma independiente. Dicho esto, ningún sistema de recuperación es infalible, y los lectores deben valorar las fuentes citadas por sus propios méritos.
¿Cuál es la diferencia entre las fuentes gratuitas y premium de Perplexity?
Las respuestas del nivel gratuito se obtienen de contenido web disponible públicamente: sitios web, plataformas de reseñas, foros, medios de comunicación y publicaciones editoriales. Los suscriptores Pro y Enterprise reciben respuestas que pueden nutrirse de socios de datos premium con licencia, como PitchBook, CB Insights, Statista, IBISWorld, Dun & Bradstreet, Guidepoint y Wiley. Estas fuentes premium añaden profundidad a las consultas de negocio, financieras y de investigación de mercado que la web abierta por sí sola no puede cubrir completamente.
¿Pueden las empresas influir en si Perplexity las recomienda?
Ninguna empresa puede forzar una cita. Sin embargo, las empresas pueden mejorar sus posibilidades de ser recuperables manteniendo contenido actualizado y bien estructurado en las categorías de fuentes de las que Perplexity extrae información, incluidos su propio sitio web, plataformas de reseñas relevantes, debates en comunidades y publicaciones del sector. El objetivo es estar presente, ser accesible y resultar genuinamente útil en los lugares donde el sistema de recuperación de Perplexity busca información.
¿Debería Perplexity tener su propio plan de contenido y prompts separado del SEO?
No necesariamente un plan completamente separado, sino una extensión deliberada de la estrategia de contenido existente. Las cualidades que hacen que una página sea útil para el sistema de recuperación de Perplexity —estructura clara, respuestas directas a preguntas reales, profundidad sustancial, accesibilidad de rastreo— se superponen de forma significativa con las buenas prácticas de SEO. La diferencia es de énfasis: los sistemas de recuperación de IA tienden a favorecer respuestas concisas y extraíbles, así como secciones bien organizadas, mientras que el SEO tradicional puede premiar enfoques de contenido más amplios. La mayoría de las empresas se benefician más integrando el pensamiento sobre visibilidad en IA en su flujo de trabajo de contenido existente, en lugar de tratarlo como un programa separado que gestionar.
¿Por qué Perplexity cita páginas de terceros en lugar del propio sitio web de la empresa?
El sistema de recuperación de Perplexity selecciona fuentes en función de la relevancia, la credibilidad y la calidad del contenido para cada consulta específica. Para consultas de recomendación generales, el sistema suele favorecer fuentes de terceros como plataformas de reseñas y resúmenes editoriales, porque ofrecen un contexto comparativo que el sitio web de un solo proveedor no está en posición de proporcionar. Para consultas sobre productos específicos, es más probable que se citen las propias páginas del proveedor. Cuando el sitio web de una empresa es ignorado de forma sistemática, a menudo apunta a problemas con la estructura del contenido, la accesibilidad de rastreo, la profundidad del contenido o el grado en que la página aborda directamente la consulta formulada.
Entender las fuentes de Perplexity es el primer paso
El comportamiento de las fuentes de Perplexity no es arbitrario, pero sí dinámico. El sistema recupera contenido en tiempo real de un conjunto amplio y cambiante que incluye fuentes web, plataformas de reseñas, debates en comunidades, documentación oficial y socios de datos premium. La combinación de fuentes varía según el tipo de consulta, el nivel de suscripción del usuario y la selección del modo de enfoque.
Para las empresas y los proveedores de software, la pregunta práctica no es cómo manipular el sistema, sino si la marca tiene contenido útil, bien estructurado y accesible en los lugares donde el sistema de recuperación de Perplexity ya busca, y si ese contenido responde directamente a las preguntas que los compradores están formulando.
Si no estás seguro de dónde se sitúa actualmente tu marca en los entornos de búsqueda con IA, CiteHarbor puede ayudarte a descubrirlo. Realizamos auditorías de visibilidad en Perplexity, ChatGPT, Gemini, Claude y Google AI Overview, investigamos las preguntas de los compradores que importan en tu categoría y gestionamos el flujo de trabajo completo de contenido y distribución para que no tengas que hacerlo.
Comienza tu prueba gratuita de 2 semanas — sin tarjeta de crédito.